
Mart ayında Meta'nın Denetleme Kurulu, şirkete 'kamuya verdiği sözleri tutması ve kendi araçlarını kullanması' çağrısında bulunarak platformlardaki aldatıcı yapay zeka içeriklerinin yayılmasını engellemesini istemişti. Meta bu çağrıya Temmuz ayında Content Seal'i tanıtarak yanıt verdi. Bu sistem, şirketin yeni yapay zeka modeli tarafından oluşturulan görsellere görünmez bir filigran ekliyor. Ancak bu özellik, şirketin Muse görsel ve video üretim araçlarını duyurduğu açıklamada neredeyse bir dipnot olarak kaldı.
Yapay zeka etiketleme sistemlerini yakından takip eden biri olarak Content Seal'in bana pek güven vermediğini söylemeliyim. Halihazırda C2PA Content Credentials ve Google'ın SynthID'i gibi çok daha yerleşik çözümler varken Meta'nın kendi sistemini çok daha geç bir tarihte piyasaya sürmesi anlamsız görünüyor. Konuyu biraz araştırdıktan sonra Meta'nın neden kendi sistemini geliştirdiğine dair ikna edici bir gerekçe bulamadım.
Meta'nın açıklamasına göre Content Seal, SynthID ile benzer şekilde çalışıyor. İnsan gözüyle görülemeyen filigran, yapay zeka tarafından oluşturulan görsellere 'gizli bir kaynak sinyali' gömüyor. Bu sinyal daha sonra bir tespit aracı tarafından taranarak kullanıcıların deepfake'leri gerçek içeriklerden ayırt etmesine yardımcı oluyor. Meta ayrıca SynthID gibi Content Seal filigranlarının da görsel 'kırpılsa, sıkıştırılsa, yeniden boyutlandırılsa veya ekran görüntüsü alınsa' bile bozulmadan kalabildiğini ve tespit edilebildiğini söylüyor.
Peki Content Seal işlevsel olarak aynı şeyi yapıyorsa neden SynthID'i benimsemediler? Meta zaten Google ile birlikte ayrı bir Content Credentials standardını destekleyen İçerik Kaynağı ve Orijinalliği Koalisyonu'nun (C2PA) yönlendirme komitesinde yer alıyor. Yani yapay zeka tespiti konusunda başkalarıyla işbirliği yapmaya istekli olduklarını göstermişlerdi. Üstelik SynthID, OpenAI tarafından da benimsendi; yani Google, şeffaflığı artırmak adına teknolojisini rakip yapay zeka sağlayıcılarına açmaya da razı.
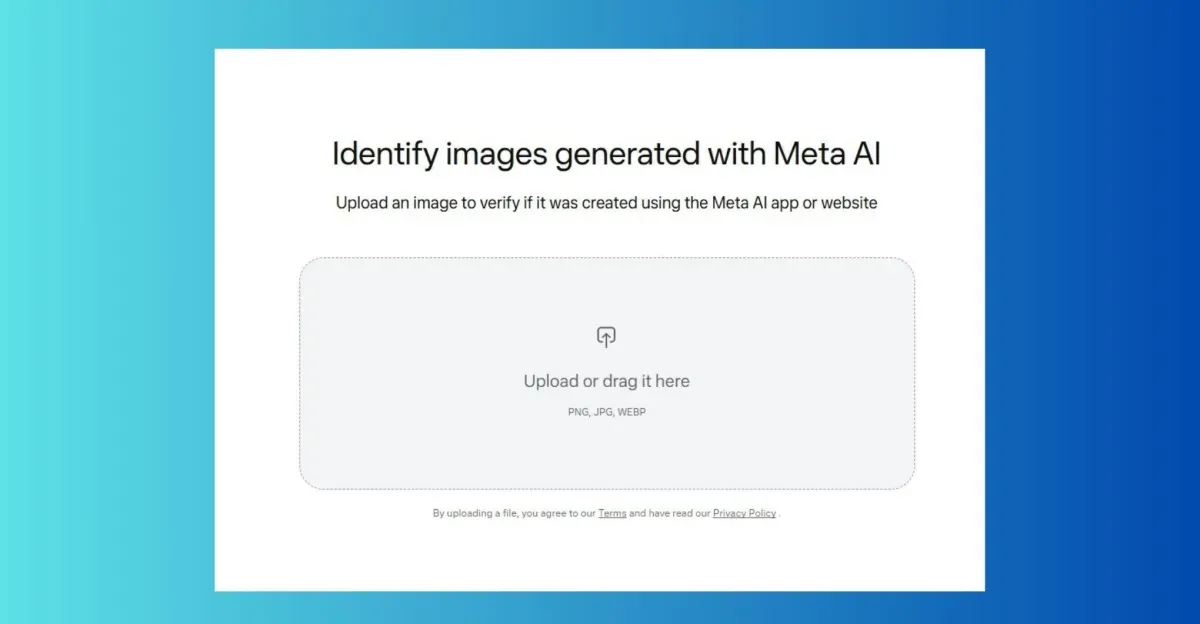
Content Seal'in Google'ın sistemine olan bu benzerliklerine rağmen mevcut haliyle birkaç önemli sınırlaması var. Şu an için kullanıcılar Content Seal filigranlarını yalnızca Meta'nın test ettiği özel bir web aracıyla tespit edebiliyor. Yani Meta, Google'ın Gemini'de yaptığı gibi bu tespit yeteneklerini Meta AI sohbet robotuna entegre etmiş değil. Ancak bu özelliğin geliştirilme aşamasında olduğu anlaşılıyor. Meta sözcüsü Faith Eischen, The Verge'e yaptığı açıklamada 'insanların yapay zeka içerikleriyle karşılaştıkları yerlere tespit özelliğini yaklaştırmanın yollarını araştırdıklarını' söyledi. Oysa yapay zeka tespitine en çok ihtiyaç duyulan yer tam da burası ve bu ihtiyaç uzun süredir var. Peki neden bu özellik lansmanda sunulmadı?
Filigranın kendisi de yalnızca Meta AI uygulaması ve Meta.ai web sitesindeki Muse modeli tarafından oluşturulan görsellere uygulanıyor. Bu da kullanıcıların Meta'nın eski yapay zeka modelleriyle oluşturulmuş içerikleri tespit edemeyeceği anlamına geliyor. Video desteği de henüz mevcut değil, ancak Meta bunun 'yakında' geleceğini söylüyor.
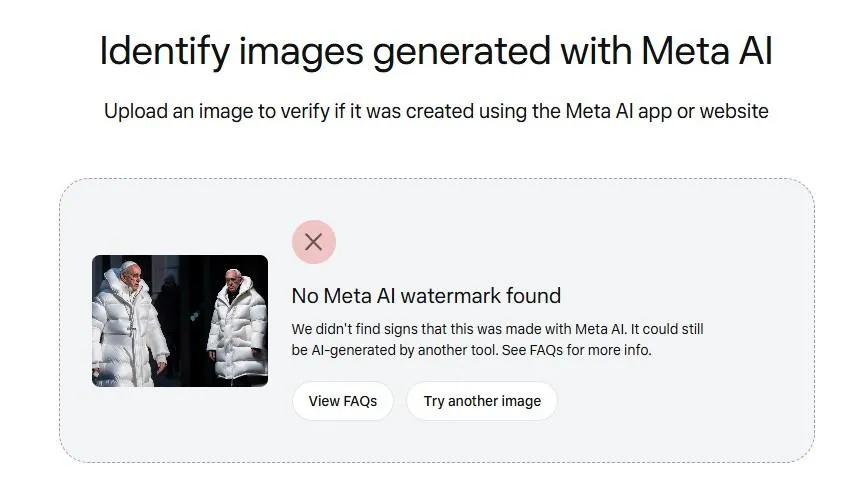
Meta, Content Seal tespit aracıyla görselleri kaç kez kontrol edebileceğinize dair günlük bir sınırlama getirmiş durumda. Eischen bu sınırlamanın 'normal kullanımı' desteklerken tespit sisteminin kötüye kullanılmasını önlemek için tasarlandığını söyledi. Meta bu tür bir kötüye kullanımın ne olabileceğini netleştirmedi - muhtemelen filigranlı içeriğin tespit edilmesini engellemek için sistemi kırmaya yönelik girişimler kastediliyor. Google ve OpenAI'in tespit araçlarında da benzer hız sınırlamaları var. C2PA ise kullanıcıların içerik kontrol edebilme sayısını sınırlamayan tek sistem olarak öne çıkıyor. Tespit konusundaki herhangi bir sınırlama, yapay zeka şeffaflığını ölçekte iyileştirme hedefine ters düşüyor. Bu da Meta'nın sisteminin SynthID'den daha iyi bir şey yapma fırsatını kaçırdığı anlamına geliyor.
Meta'nın Facebook ve Instagram gibi kendi platformlarında yapay zeka etiketleri uygularken, Eischen'in belirttiğine göre 'Content Seal filigranının yanı sıra' belirtilmemiş meta veriler de kullanılıyor. Meta'ya TikTok ve LinkedIn gibi yapay zeka içeriğini tarayıp etiketleyen diğer çevrimiçi platformlara Content Seal'in nasıl tespit edileceğini öğretip öğretmediğini sorduğumda Eischen, şirketin 'kullanıcıların mümkün olan en iyi deneyimi yaşaması için sektördeki meslektaşlarıyla çalışmaya kararlı olduğunu' söyledi.
Bu da standarda yönelik daha geniş desteğin henüz tamamlanmadığı ve Muse tarafından oluşturulan görsellerin Meta'nın kendi platformları dışında etkili bir şekilde etiketlenemeyebileceği anlamına geliyor. Meta'nın Muse modelini kullanarak oluşturduğum bir test görselini Gemini'ye ve resmi C2PA tespit portalına yüklediğimde, hiçbiri görselin yapay zeka tarafından oluşturulduğunu doğrulayamadı. Ayrıca Content Seal'in SynthID ve Content Credentials ile birlikte görüntü ve video dosyalarına bu diğer standartlara müdahale etmeden uygulanıp uygulanamayacağı sorusu da var. Meta bu konuda resmi bir açıklama yapmadı.
Eischen, 'Diğerleri gibi biz de Content Seal'i kendi teknik özelliklerimize ve ürünlerimize göre geliştirdik. Ekosistem genelinde bu sorunu çözmek için birden fazla yaklaşımın birlikte çalışması gerekiyor ve bu çabaya katkıda bulunmaktan mutluluk duyuyoruz' dedi. 'Yakında Content Seal hakkında daha fazla bilgi paylaşacağız.'
Content Seal yalnızca Meta'nın en yeni yapay zeka modeliyle oluşturulan görselleri tespit edebildiğine göre, şirketin tüm bu süre boyunca ne yaptığını merak etmemek elde değil. Meta, 2023'ten beri yapay zeka görsel üretim araçları sunuyor; yani kendi özel sistemi tarafından tespit edilemeyecek çok sayıda sahte içerik üretmiş durumda. Ayrıca 2023'te Instagram ve Facebook'a yapay zeka etiketleri getirmişti, ancak bu etiketler o dönemde gerçek fotoğrafları yanlışlıkla 'Yapay Zeka Tarafından Oluşturuldu' olarak işaretleyerek birçok fotoğrafçıyı kızdırmıştı.
Üç yıl geçmesine rağmen Meta, kendisini hem yapay zeka içeriği üreten bir fabrika hem de bunu tespit eden bir çözüm olarak nasıl konumlandıracağı konusunda hâlâ emin değil. Özellikle kendi platformlarında. Meta'nın üst düzey yöneticileri bile bundan sonra ne yapmaları gerektiği konusunda kararsız görünüyor.
Lenny Rachitsky'nin podcast'ine verdiği bir röportajda Instagram'ın başındaki isim Adam Mosseri, yapay zeka içeriğinden hoşlanmayan kişilerin bunu sosyal akışlarından uzak tutmasına izin verilmesi fikrini başta benimsedi. Bu, güvenilir bir yapay zeka etiketleme sistemi gerektiren bir filtreleme özelliğine benziyor. Hatta Mosseri, yapay zekanın sağlayamayacağı bir şey olarak özgünlüğün daha da değerli hale geleceğini öne sürdü.
Mosseri, 'Sentetik içeriğin bol olduğu bir dünyada insanların yaratıcılığı, özgünlüğü ve insanları daha çok arayacağını düşünüyorum, daha az değil' dedi.
Ancak aynı röportajda Mosseri, 'yapay zeka içeriğini filtrelemememiz gerektiğini' söylerken 'içeriğin yapay zeka içeriği olup olmadığını bilmenize izin vermeliyiz' ifadesini kullandı. Mosseri ayrıca daha önce dile getirdiği bir görüşü yineleyerek 'sahte medyadan ziyade gerçek medyayı parmak iziyle tanımlamanın daha pratik olabileceğini' söyledi. Bu, Meta'nın uygulanabilir bir yapay zeka etiketleme sistemi geliştirme yeteneğine pek güvenmediğini gösteriyor. Şirketin sosyal platformlarını 'Karides İsa' ve diğer üretilmiş beyin çürütücü içerikler için bir çöplüğe dönüştürmesi arasında bunu yapmak için bolca zamanı vardı, ancak Content Seal lansmanı hâlâ aceleyle çıkarılmış gibi görünüyor.
Sistem, benzer ve yerleşik SynthID sistemine kıyasla tüketicilere hiçbir benzersiz fayda sunmuyor. Aksine, insanların yapay zeka içeriğini doğrulamak için atlaması gereken bir engel daha yaratıyor. Belki de Meta, OpenAI'in yaptığı gibi Google'ın filigran standardını benimsemeliydi. Facebook ve Instagram kullanıcıları öyle olsa daha iyi durumda olabilirdi. Eischen bana Meta'nın yıllardır açık kaynaklı filigran araştırmalarına katkıda bulunduğunu, yani bu teknolojiyi bir gecede geliştirmediklerini söylüyor. Ancak bunun karşılığında daha iyi bir tüketici deneyimi beklerdim.
Meta kendi çözümlerinde ısrar edecekse, yapay zeka şeffaflığı konusunda gerçekten ciddi olduğunu kanıtlamak için yarı pişmiş bir SynthID klonundan daha fazlasına ihtiyacı var. En azından daha güvenilir bir sisteme. Reuters, Content Seal'in kırpıldıktan sonra test ettiği Muse tarafından oluşturulan görsellerin yarısından fazlasını tespit edemediğini zaten ortaya koydu.