Yeni bir yaklaşım olan ters oyun teorisi, güçlü yapay zekâ modellerini kontrol etmeyi amaçlıyor; modellerin kurallara uymasını teşvik eden sistemler tasarlıyor.
Yapay zekâ modelleri daha yetenekli hale geldikçe güvenlik araştırmacıları onları insan istekleriyle uyumlu hâle getirmek için çabalıyor. Başka bir deyişle, kontrolden çıkan ajanların yasa dışı iş yapmaması, yetkisiz sunuculara sızmaması ya da büyük kentlere zehirli gaz salıp herkesi öldürmemesi gerekiyor.
Şimdiye kadar bu çalışmalar büyük ölçüde yapay zekânın beynine bakıp ne düşündüğünü anlamaya ya da modelleri sevdiğimiz değerlere uyması için eğitmeye odaklandı. Örneğin Claude’un bir anayasası var; bir çeşit ahlaki kod.
Sorun şu ki bu teknikler pek iyi işlemiyor gibi görünüyor: Modellerin testlerde kasıtlı olarak düşük performans gösterdiği, niyetlerini gizlediği ve değerlendiricilerini yanıltmaya çalıştığı görüldü.
Şimdi bazı uyum araştırmacıları, mekanizma tasarımı olarak da bilinen ters oyun teorisinin daha iyi sonuç verebileceğine inanıyor. Oyun teorisi belirli kurallar verildiğinde rasyonel aktörlerin nasıl davranacağını tahmin etmeye çalışırken, ters oyun teorisi teşvik etmek istediğimiz davranışları ortaya çıkaracak kurallar tasarlamaya çalışır.
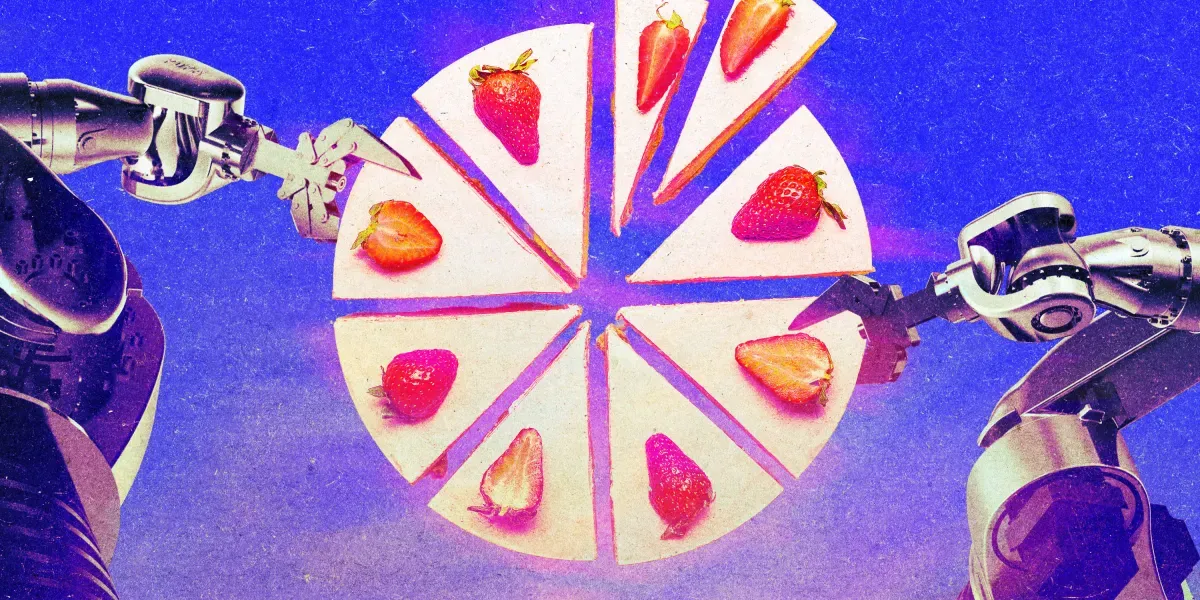
Gerçek dünyada mekanizma tasarımına örnek olarak iki kişiye pasta bölme stratejisi gösterilebilir: Biri pastayı keser, diğeri parçaları seçme hakkını alır. Bu, kesenin parçaları mümkün olduğunca eşit yapmasını teşvik eder. Diğer örnekler arasında yoğun saatlerde sürücülerin müsait olmasını sağlayan araç çağırma uygulamalarındaki talep fiyatlandırması ve ikinci fiyat açık artırmaları yer alır; burada kazanan teklif veren en yüksek teklif yerine ikinci en yüksek teklif fiyatı öder. Platformlar çevrimiçi reklam satmak için bu açık artırmaları kullanır çünkü alıcıların ödemeye istekli oldukları maksimuma yakın teklif vermelerini teşvik eder.
Yapay zekâda mekanizma tasarımı, öncü modellerin iç işleyişi hakkında uyumlu olduklarından emin olmak için asla yeterince anlayamayacağımız varsayımından yola çıkar. Bu da neyin altında olduğuna bakılmaksızın ajanların istediğimiz şekilde davranmasını teşvik edecek mekanizmalar tasarlamamız gerektiği anlamına gelir.
MIT ekonomisti Stephen Morris’un Yale ve Columbia’dan meslektaşlarıyla birlikte kaleme aldığı yakın tarihli bir ön baskı makalesi, ajanların testlerde olduğundan kötüymüş gibi davranarak güvenlik mekanizmalarını tetiklemekten kaçınmasını engelleyebilecek bazı olası mekanizmalar önerdi.
Bir model yalnızca teste ne kadar iyi performans gösterdiğine göre değil, cevaplarının ikinci bir modelin söyleyeceği şeyi ne kadar iyi tahmin ettiğine göre ödüllendirilebilir. Bilerek aptal davranmak kaybedilen bir bahis hâline gelir. Morris, “Yapay zekâ ajanlarının diğer yapay zekâ ajanlarının neler başarabileceğine dair çok iyi bir anlayışı var” diyor. “Bu yüzden bu çapraz kontrolün daha pratik çalışabileceği bir bağlam gibi görünüyor.”
Makale ayrıca ajanları birbirine karşı oynatmayı, en iyi performans göstermelerini teşvik eden rekabetçi bir dinamik yaratmayı ya da zıt yönde önyargılı olduğu bilinen ajanları eşleştirmeyi ve çıktılarının ne kadar yakın eşleştiğine bağlı olarak ödüllendirmeyi öneriyor; böylece optimal bir sonuca ulaşmaları teşvik ediliyor.
Princeton’da bilgisayar bilimi profesörü Elad Hazan’ın öngördüğü ikinci bir yaklaşım, insan toplumunun insanları uyumlu tutmak için kullandığı yöntemlerden ilham alan mekanizmalar tasarlamaktır: sosyal normlar, adalet sistemi, serbest piyasa kapitalizminin parasal teşvikleri. Hazan, “Süper zeki yapay zekâyı uyumlu hâle getirmek istiyoruz” diyor. “Önce insanlardan bahsetsek neden olmasın? İnsanları nasıl uyumlu hâle getiriyoruz?”
Hazan’ın önerdiği mekanizma, yapay zekâ modellerinin sırayla sorunları çözen çözücüler ya da başkalarının işini kontrol eden denetçiler rolünü üstlenmesini içeriyor. “Bir ajan kolluk kuvveti gibi davranır; diğer ajan vatandaş gibi davranır” diyor.
Eğitim sırasında modeller sonuçlara göre ödüllendirilir: Hile yaparken yakalanan çözücüler cezalandırılır, hileyi yakalayamayan denetçiler de cezalandırılır. Denetçiler ve çözücüler arasında anlaşmazlık çıktığı durumlarda dava duruşmaya gönderilebilir; belki bir insan uzman kim haklı olduğuna karar verir.
Hazan, ajanların birbirleriyle iş birliği yapma riskinin olduğunu kabul ediyor; denetçilerin denetlemesi gereken şirketlerle iş birliği yaptığı ya da yolsuz polis memurlarının suçlularla iş birliği yaptığı gibi. Ancak bu sorun, yakalanmanın riskine değmeyecek kadar denetçileri iyi ödüllendirerek çözülebilir; polis maaşları için para sıkı olan gerçek dünyaya kıyasla yapay zekâ eğitimi dünyasında çok daha kolay. Denetçilerin denetçilerini gizli müşteri kullanmaya benzer tekniklerle denetlemek de çözüm olabilir.
Hazan, 1960’larda rasyonel suçlu fikrini ortaya atan ekonomist Gary Becker’in Nobel ödüllü çalışmalarına işaret ediyor. Suçlular doğası gereği kötü insanlar oldukları için yasa bozmazlar; onun yerine sunulan teşvikler göz önüne alındığında en rasyonel seçim olduğunda yaparlar. Suç, elde edilen gelir potansiyel cezayı aştığında mantıklı hâle gelir.
Uyumun bir modelin özelliği olarak değil, belirli bir andaki davranışının tanımı olarak düşünülmesi gerektiğini savunuyor. “Sen, yani, iyi bir insansın” diyor. “Uyumlu musun? Bilmiyorum. Muhtemelen çoğu zaman uyumlusun ama uyumlu olmadığın bir durum olabilir.”
Yapay zekâya mekanizma tasarımını uygulamanın olası bir sorunu: Bu yaklaşım yapay zekâ ajanlarının rasyonel davrandığı varsayımına dayanır. Mekanizma tasarımı, insanların çoğu zaman ekonomik modellerin söylediği şekilde davranmadığı insanlarla karışık bir geçmişe sahip.
İronik bir durum: Ekonomistler on yıllardır insan davranışını matematiğe indirgemeye çalıştı ve şimdi büyük dil modellerinde insan dilinde çalışan ve aynı derecede anlaşılmaz olabilen matematiksel sistemler inşa ettik. Yapay zekâ modelleri makineden çok insana benzeyen davranışlar sergiliyor ve anlaşılması ve açıklanması zor ince faktörlerden etkilenebiliyor. Flatiron Enstitüsü’nde araştırma görevlisi ve mekanizma tasarımı ile yapay zekâ güvenliği üzerine yazan Helen Qu, “Onların teşviklere yanıt vereceğini varsaymak makul mü?” diye soruyor.
Morris, “Açıkçası yapay zekâlar rasyonel değil” diyor. “Sadece çalışan algoritmalar.” Ancak ekonomistlerin insanlarla bulduğu gibi, onları rasyonelmiş gibi ele almak, davranışlarını tahmin etmeye ve kontrol etmeye yardımcı oluyorsa hâlâ faydalı olabilir.
Qu, mekanizma tasarımını yapay zekâ modellerini uyumlu tutmak için yorumlanabilirlik, düzenleme ve eğitimle birlikte kullanılan, onların yerine geçen değil, derinlemesine savunma stratejisinin yalnızca bir katmanı olarak görüyor. Ancak yaklaşımın gerçek öncü modellerde uygulanabilmesi için yanıtlanması gereken çok soru var. Örneğin bu teorilerin gerçek modellerde nasıl uygulanacağı ya da bir görev için tasarlanan mekanizmaların pratikte başka bir göreve taşınıp taşınmayacağı belli değil. Modeller hiç kimsenin öngörmediği boşluklar bulabilir. Anthropic ve OpenAI, bu konuda çalışıp çalışmadıkları yönündeki sorulara yanıt vermedi.
Bu mekanizmalar neye benzerse benzsin, nihayetinde en büyük mekanizma olan serbest piyasaya oturmak zorunda kalacak. Hazan, “Ekonomi kurallarına göre oynuyoruz” diyor. Daha uyumlu bir model dünya için iyi olabilir ama daha yavaş ya da daha pahalıysa, mevcut kural ve düzenleme sistemimiz öncü laboratuvarları onu yayınlamaya gerçekten teşvik ediyor mu?
Piyasa hakkında “İnsanoğluna çok refah sağlayan bir mekanizma” diyor, “ama aynı zamanda çok korkunç bir şeye de yol açabilir.” Belki de daha iyi bir mekanizma tasarımına gerçekten ihtiyaç duyanlar laboratuvarların kendileridir.