Bilgisayar programlamayla en azından dolaylı olarak ilgilenmiş herkes bilir ki modern yapay zekâ kod asistanları ve ajanları büyük miktarda işlevsel kod üretmede son derece verimli olabiliyor. Bu araçları kullanan yazılımcılar da aynı zamanda üretilen kodun doğruluğuna güvenmemeleri gerektiğini bilir; bu yüzden yapay zekâ çıktısının gözden geçirilmesi için ciddi bir çaba harcanması gerekiyor.
Yüzlerce firmadaki gerçek kodlama uygulamalarını inceleyen yeni bir çalışma, insan kod incelemesinin yapay zekâ kodlama araçlarının genel verimliliği için önemli bir "darboğaz" oluşturduğunu buldu ve bu durumun "firmaların yazılım çıktısını artırması ya da istihdamı azaltması için somut kanıt" bulunmadığı sonucunu doğuruyor. Araştırmacılar, kodlama aşamasındaki olası verim artışının "üretim sürecindeki aşağı akış kısıtları tarafından emildiğini" tespit etti; "kod inceleme süreci belirgin şekilde uzuyor, pull requestlerin revizyon gerektirme olasılığı artıyor ve denetçiler daha fazla yorum bırakıyor."
Bir kez kes, iki kez ölç
Bu sonuçlara ulaşmak için Harvard Üniversitesi araştırmacıları Fiona Chen ve James Stratton, mühendislik ekiplerinin ayrıntılı çıktısını ölçen Jellyfish'in toplu analitik verilerinden yararlandı. Söz konusu veri, 2021'den 2026 Mart'ına kadar 700'den fazla ilgili yazılım geliştirme firmasında 700 binden fazla çalışanı kapsayan 300 milyon bireysel "iş olayı" (örneğin commit ve pull request) ve sorun yönetimi yazılımı verisini içeriyor.
Firmalarda yapay zekâ araçlarının etkisini değerlendirmek için araştırmacılar, doğrudan ölçülen yapay zekâ kullanımını ve GitHub etkinliğinin analizini birleştirdi. Böylece her şirketin insan yazarı ağırlıklı kodun tamamlanmasına yardımcı olabilen yapay zekâ kod asistanlarını ve/veya istemlere dayalı olarak özerk şekilde kod yazıp gönderen yapay zekâ kodlama ajanlarını iş akışlarına ne zaman dahil etmeye başladığını belirlediler. Araştırmacılar daha sonra bu araçların farklı zamanlarda farklı kuruluşlarda tanıtılmasından önce ve sonra kilit değişkenler üzerinde bir "farkların farkı" regresyonu yapmak için karmaşık bir matematik uyguladı.
Üretilen ham kod açısından sonuçlar net ve keskin. Araştırmacılar yazıyor ki bir firmada yapay zekâ kodlama ajanlarının tanıtılması ortalama olarak üretilen toplam kod satırında yüzde 30 artış, toplam commit sayısında yüzde 20 artış ve pull requestlerde yüzde 23 artışa yol açıyor. Ancak tüm bu ekstra kod, firma düzeyinde yazılım çıktısında doğrudan iyileşmeye dönüşmüyor. Aksine, Jira gibi araçlarla izlenen Sorunlar ve Epikler (yani bütünsel yazılım özellikleri) için çözüm oranı, yapay zekâ araçlarının tanıtılmasından sonra istatistiksel olarak anlamlı bir şekilde değişmedi. Araştırmacılar ayrıca yapay zekâ tanıtımı boyunca bu Jira ile izlenen sorunların büyüklük veya karmaşıklığında bir "bileşimsel kayma" da bulmadı.
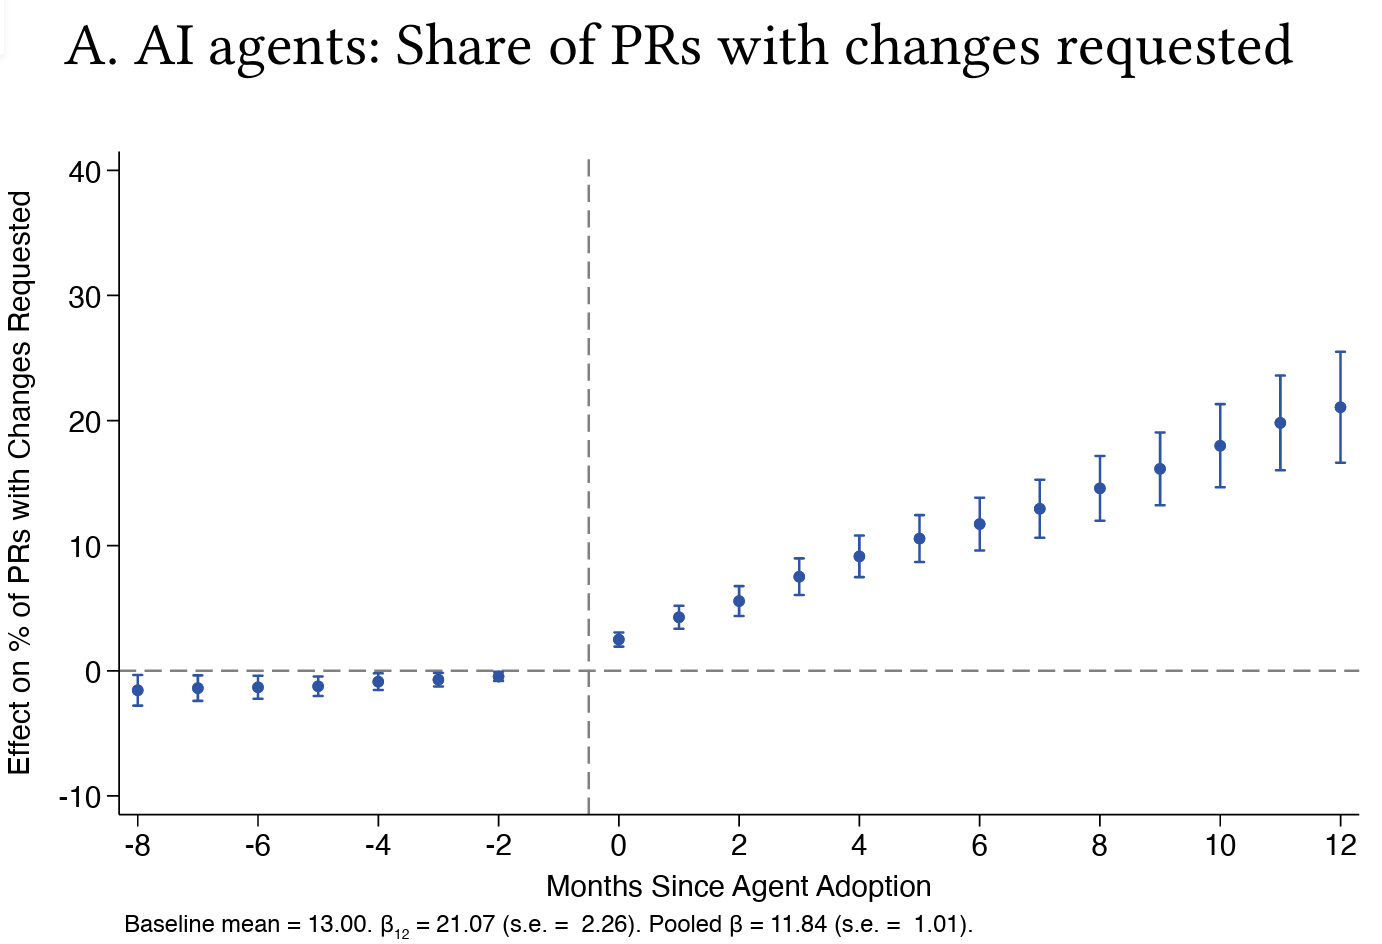
Bu tutarsızlığın nedeni doğrudan kod inceleme sürecinde bulunabiliyor; yapay zekâ kodlama ajanlarının tanıtılmasından sonra ortalama olarak belirgin şekilde daha uzun sürüyor. Genel olarak, bir pull requestin gönderilmesi ile kod tabanına birleştirilmesi arasındaki ortalama "inceleme süreci" süresi, yapay zekâ ajanlarının tanıtılmasından sonra ortalama yüzde 49 şişiyor. Bu etki daha ayrıntılı verilerde de görülebiliyor; araştırmacılar yazıyor ki yapay zekâ ajanı geçişinin ardından "değişiklik talep edilen pull requestlerin payı neredeyse ikiye katlanıyor ve pull request başına yorum sayısı yüzde 35 artıyor."
Bu değişime yanıt olarak araştırmacılar, yapay zekâ ajanlarının tanıtılmasından sonra kod incelemesi yapan çalışanların payında yüzde 14 artış buldu. Ayrıca Jellyfish'teki toplam aktif çalışanlara bakıp bu firmaları LinkedIn verileriyle çapraz kontrol ettiklerinde "yapay zekânın istihdamda önemli bir değişime yol açtığını söyleyemeyeceklerini" yazdılar.
Yapay zekânın bu inceleme sürecine de teorik olarak yardımcı olabileceği doğru olsa da, araştırmacılar şimdiye kadar bu etkinin marjinal kaldığını buldu. Mart 2026 itibarıyla ölçülen firmaların yüzde 80'i bir tür yapay zekâ kod incelemesi kullanmasına rağmen, yapay zekâ ajanları tüm inceleme yorumlarının yalnızca yüzde 23,3'ünden ve tüm pull requestlerin yüzde 10,8'inden sorumluydu; bu da bu çalışmanın büyük çoğunluğunun hâlâ insanlardan kaynaklandığını gösteriyor.
Yapay zekâ ajanları elbette kodlama dünyasında nispeten yeni bir parça ve bu çalışmanın Mart 2026 veri kesim tarihinden bu yana çıktıları için önemli güncellemeler ve iyileştirmeler oldu. Ve çalışmadaki firmaların yüzde 95'i bu noktaya kadar yapay zekâ kodlama ajanlarını uygulamış olsa da, birçoğu bunları en iyi ne zaman ve nasıl kullanacakları konusunda hâlâ bir öğrenme sürecinden geçiyor. Yazılım mühendisliği ekipleri yapay zekâ ajanlarının artıları ve eksileri konusunda daha fazla deneyim kazandıkça bu tür "kodlama süresi karşısında inceleme süresi" ödünleşimleri iyileşebilir.
Şu an için kodunuzu yapay zekânın yazmasına izin vermek çift taraflı bir kılıç gibi görünüyor; kodlama hızındaki artış, insan kod inceleme süresi ve çabasındaki benzer artışla dengeleniyor. Bu, çoğu şirket için yapay zekâ kodlama ajanlarını çalışır hale getirmek için harcanan kayda değer zaman ve harcamanın gerçekten buna değip değmeyeceği sorusunu akla getiren türden bir sonuç.