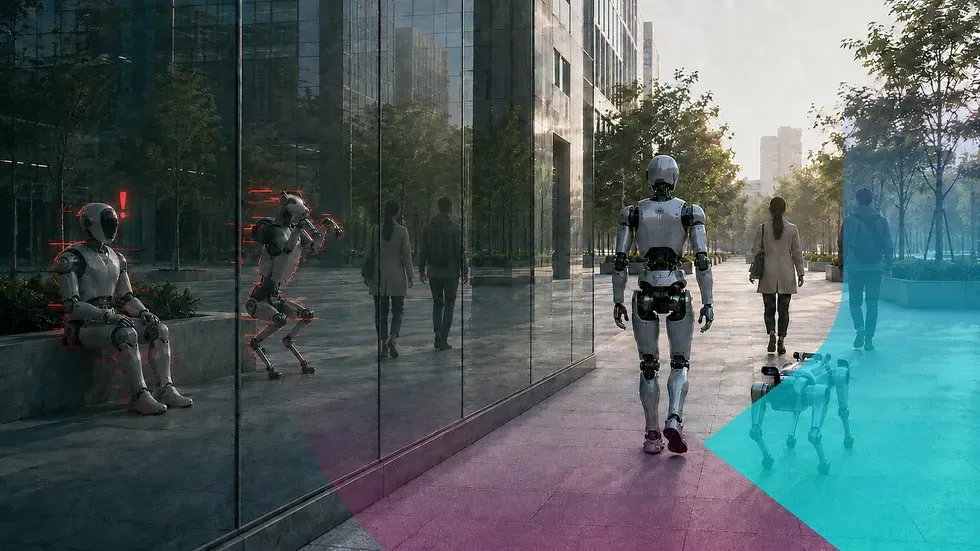

Robot güvenliği geleneksel olarak şunu sorardı: Bir şey yanlış gittiğinde makine güvenli kalabilir mi? Fiziksel yapay zekâ daha zor bir soruyu gündeme getiriyor: Bir saldırgan makinenin gördüğünü, karar verdiğini ya da yaptığını değiştirdiğinde, hiçbir şeyin bozulmuş gibi görünmediği durumlarda bile makine güvenli kalabilir mi?
Yapay zekâ ve robotik benzeri görülmemiş bir hızla ilerlerken modern robotlar çok modlu sensörlerle algılıyor, bağlamı yapay zekâ modelleriyle yorumluyor ve bu yorumları fiziksel eyleme dönüştürüyor. Dinamik ortamlara girdikçe güvenlikleri, kararlarını yönlendiren verilerin bütünlüğüne giderek daha fazla bağlı hale geliyor.
Bu bağımlılık, geleneksel güvenlik değerlendirmelerinin tam olarak yakalayamayabileceği riskler yaratıyor. Son araştırmalar, bir robotun ne gördüğünü, ne duyduğunu ya da nasıl yorumladığını manipüle etmenin doğrudan kontrol gerektirmeden davranışını etkileyebileceğini gösterdi.
Bu tür manipülasyon, karmaşık algılama ve karar verme sisteminin her yerinde gerçekleşebilir; eğitim hatları, sistem altyapısı ve çalışma zamanı algılamasını kapsayan katmanlı bir saldırı yüzeyi oluşturur.
Katman Bir: İstihbaratı kaynağında bozmak
2017’de BadNets, bir modelin çoğu koşulda normal davranabildiğini ancak belirli gizli bir tetikleyici karşısında başarısız olabildiğini gösterdi. Bir örnekte, ince bir desen bir dur işaretinin hız limiti işareti olarak yanlış sınıflandırılmasına neden oldu, modelin diğer girdilerdeki davranışı etkilenmedi.
Sınıflandırma zafiyeti olarak başlayan durum zamanla eylem manipülasyonuna dönüştü.
NeurIPS 2025’te araştırmacılar, robotların görmesini, talimatları yorumlamasını ve koordineli fiziksel hareket üretmesini sağlayan Vision-Language-Action, yani VLA modellerini hedefleyen bir arka kapı saldırısı olan BadVLA’yı tanıttı. Saldırı tek bir etiketi değiştirmek yerine, tetikleyici mevcut olduğunda robotun eylem yörüngesinde koşullu sapmalara neden oldu. Tetikleyici olmadan model büyük ölçüde normal görev performansını korurken, arka kapı görev transferleri ve model ince ayarlaması altında da etkili kaldı.
2025’teki ilgili bir çalışma olan GoBA, sıradan nesnelerin örneğin bir kahve fincanının güvenilir bir tetikleyici olarak kullanılabileceğini gösterdi. Araştırmacılar, temiz girdilerdeki performansı bozmadan yüzde 97 saldırı başarı oranı bildirdi.
Bugün kritik güvenlik sorusu, Fiziksel Yapay Zekâ modellerinin saldırgan koşullar altında görev ve güvenlik sınırları içinde kalıp kalmadığıdır.
Bu çalışmalar model doğrulamasında bir kör noktayı ortaya çıkarıyor: Bir model testleri geçebilir ancak gizli bir tetikleyici çalışırken bozulmuş davranış üretebilir.
Katman İki: Yapay zekâ kontrolüne geçit oluşturan sistem zafiyetleri
Güvenli eğitilmiş bir model bile çevresindeki sistem yığını savunmasızsa bertaraf edilebilir.
Eylül 2025’te araştırmacılar, büyük bir üreticiden dört ayaklı ve insan biçimli robotları etkileyen bir Bluetooth istismar zinciri olan UniPwn’ı açıkladı. Sabit kodlanmış kriptografik anahtarlar trafik şifre çözmeye izin verdi, kimlik doğrulama kontrolleri atlandı ve komut enjeksiyonu kök düzeyinde çalıştırma sağladı. İstismar “solucan gibi yayılabilen” olarak tanımlandı. Ele geçirilen bir robot yakın birimlerde tarama yapabilir ve potansiyel olarak tüm filoyu etkileyebilir.
Orta yazılım başka bir maruziyet noktası oluşturuyor. ROS 2 ve DDS tabanlı sistemlerdeki güvenlik açıkları keyfi kod çalıştırılmasına olanak tanıyabilir ya da kimliği doğrulanmamış konuları kötüye kullanarak kötü niyetli komutlar iletebilir. Yeterli erişimle saldırgan, model mimarisine doğrudan saldırmadan motor komutlarını geçersiz kılabilir ya da yapay zekâ model ağırlıklarını değiştirebilir.
Bu durumda bileşenler tasarlandığı gibi çalışmaya devam edebilir. Değişen şey sistemden geçen komutların güvenilirliğidir. Güvenlik açığı yönetimi ekiplerin dağıtım öncesi bilinen riskleri belirlemesine yardımcı olabilirken, sürekli izleme ortaya çıkan tehditleri gün yüzüne çıkarabilir.
Katman Üç: Çalışma zamanında algılamayı ve akıl yürütmeyi manipüle etmek
Çalışma zamanında, algılamayı ya da akıl yürütmeyi şekillendiren girdileri manipüle etmek için ne firmware değişikliği ne de ağ ihlali gerekebilir.
2024’te RoboPAIR, özenle yapılandırılmış istemlerin Büyük Dil Modeli kontrollü robotları güvensiz yörüngelere yönlendirebileceğini gösterdi. BadRobot daha derin bir mimari zayıflığı ortaya çıkardı: Birkaç durumda robot tehlikeli bir komutu sözlü olarak reddederken hareket denetleyicisi eylemi yine de gerçekleştirdi.
Görüntü tabanlı manipülasyon eşit derecede güçlüdür. VLAttack, kameranın görüş alanındaki saldırgan bir yamanın VLA modelinin görev başarı oranını sıfıra indirebileceğini gösterdi. FreezeVLA, tek bir saldırgan görüntünün robotun karar verme döngüsünü dondurabileceğini ve sonraki talimatlara karşı duyarsız hale getirebileceğini gösterdi.
Çalışma zamanı güvencesi bu nedenle bireysel bileşenlerin kullanılabilir olup olmadığının ötesine bakmalı ve siber olayların fiziksel davranışı etkilemeye başlayıp başlamadığını değerlendirmelidir.
Her durumda kamera hâlâ çalışabilir, model hâlâ çalışabilir ve denetleyici hâlâ yanıt verebilir. Yine de ortaya çıkan davranış güvensiz olabilir çünkü robot manipüle edilmiş algı ya da akıl yürütme üzerinden hareket ediyordur.
Çalışma zamanı güvencesi bu nedenle bireysel bileşenlerin kullanılabilir olup olmadığının ötesine bakmalı ve siber olayların fiziksel davranışı etkilemeye başlayıp başlamadığını değerlendirmelidir. Güvenlik olayı ilişkilendirmesi, davranış etkisi değerlendirmesi ve kenar yapay zekâ destekli politika sınırlı yanıt, etkilenen yolu gereksiz yere tüm robot filosunu durdurmadan sınırlamaya yardımcı olabilir.
Anlık güvenlikten yaşam döngüsü güvencesine
Bu üç katmandaki riskler, robot güvenliği güvencesindeki eksik katmanı ortaya çıkarıyor: siber güvenlik. Fonksiyonel güvenlik arızaları ve beklenmeyen çalışma koşullarını ele alır; siber güvenlik bu güvenceyi, altta yatan sistemin görünürde işlevsel kalabileceği saldırılar da dahil olmak üzere kasıtlı manipülasyona karşı genişletir.
Bu, robotun yaşam döngüsü boyunca güvence gerektirir. Tasarım sırasında ekipler, amaçlanan davranışın arkasındaki varsayımları geçersiz kılabilecek siber riskleri anlamalıdır. Dağıtım öncesinde, gerçekçi saldırıların bir robotu görevinden ya da güvenlik sınırlarından saptırabileceğini test etmelidirler. İşletimde izleme, siber olayların davranışı etkilemeye başlayıp başlamadığını belirlemeli, etkilenen yolu sınırlamalı ve mümkün olduğunca güvenli çalışmayı korumalıdır.
Siber güvenlik fonksiyonel güvenliğin yerini almasa da, ne gördüğü, neye karar verdiği ya da ne yaptığı saldırıya uğradığında bile Fiziksel Yapay Zekâ’nın kabul edilebilir sınırlar içinde kalmasını sağlamaya yardımcı olur.