Elon Musk'ın SpaceXAI şirketi, Çarşamba günü Grok 4.5 modelini piyasaya sürdü. Bu, SpaceX ile xAI'nin Şubat ayında birleşmesinin ardından çıkan ilk halka açık model ve SpaceX'in Cursor'ı satın almak için yaptığı 60 milyar dolarlık anlaşmanın gölgesinde gerçekleşti. Model, kod yazarları, mühendisler ve şirketin deyimiyle 'bilgi çalışanları' olarak adlandırılan geniş bir kitleyi hedefliyor; bu kategori yazılım geliştiricilerden sözleşme inceleyen avukatlara, Excel modelleri oluşturan finans ekiplerine kadar uzanıyor.
Şirketin iddiası, modelin en iyi model olduğu yönünde değil. Aksine, en azından Batılı bir model için ucuz olduğu yönünde. Grok 4.5, milyon giriş token başına 2 dolar, milyon çıkış token başına 6 dolar maliyetle sunuluyor. Anthropic'in amiral gemisi Claude Opus 4.8 ise giriş için 5 dolar, çıkış için 25 dolar. OpenAI'in yine Çarşamba günü piyasaya sürülen yeni üst düzey modeli GPT 5.6 Sol ise giriş için 5 dolar, çıkış için 30 dolar olarak fiyatlandırıldı.
Musk, X platformunda yaptığı paylaşımda yeni modelinin aslında nerede durduğunu netleştirdi. Modeli 'Opus 4.7 ile kabaca karşılaştırılabilir, ancak çok daha hızlı' olarak nitelendirdi. Opus 4.7, Anthropic'in önceki amiral gemisi modeliydi; Opus 4.8 ise onun yerini aldı. Claude Fable 5 ise artık Anthropic'in en üst düzey modeli konumunda.
Musk, bunu bilinçli bir takas olarak çerçeveledi: ham yetenek yerine hız ve maliyet. Tesla ve SpaceX'teki mühendislerin bu modeli gerçek dünyada kullanmasını da pratik faydanın kanıtı olarak gösterdi.
Benchmark Sonuçları Ne Gösteriyor?
SpaceXAI, lansman sırasında dört benchmark sonucu yayınladı ve tablo karmaşık bir görünüm sergiliyor. DeepSWE 1.1, bir yapay zekanın geliştiriciler tarafından bildirilen gerçek yazılım hatalarını ne kadar güvenilir bir şekilde kapatabildiğini ölçüyor. Standart bir test düzeneği kullanılarak modeller adil bir şekilde karşılaştırılabiliyor ve puan, düzeltilen sorunların yüzdesi olarak hesaplanıyor. Grok 4.5 bu testte %53 puan alırken, Claude Opus 4.8 %59, GPT 5.5 ise %67 puan aldı. Anthropic'in sınır modeli Claude Fable 5 ise %70 ile listenin zirvesinde yer aldı.
Bir diğer yazılım mühendisliği problemi benchmark'ı olan SWE Bench Pro'da ise Grok 4.5 %64.7 puan alarak GPT 5.5'in bu testteki %58.6'lık puanını geride bıraktı. Ancak Opus 4.8 %69.2 ile hâlâ lider durumda. Fable 5 ise %80.4 ile zirvede.
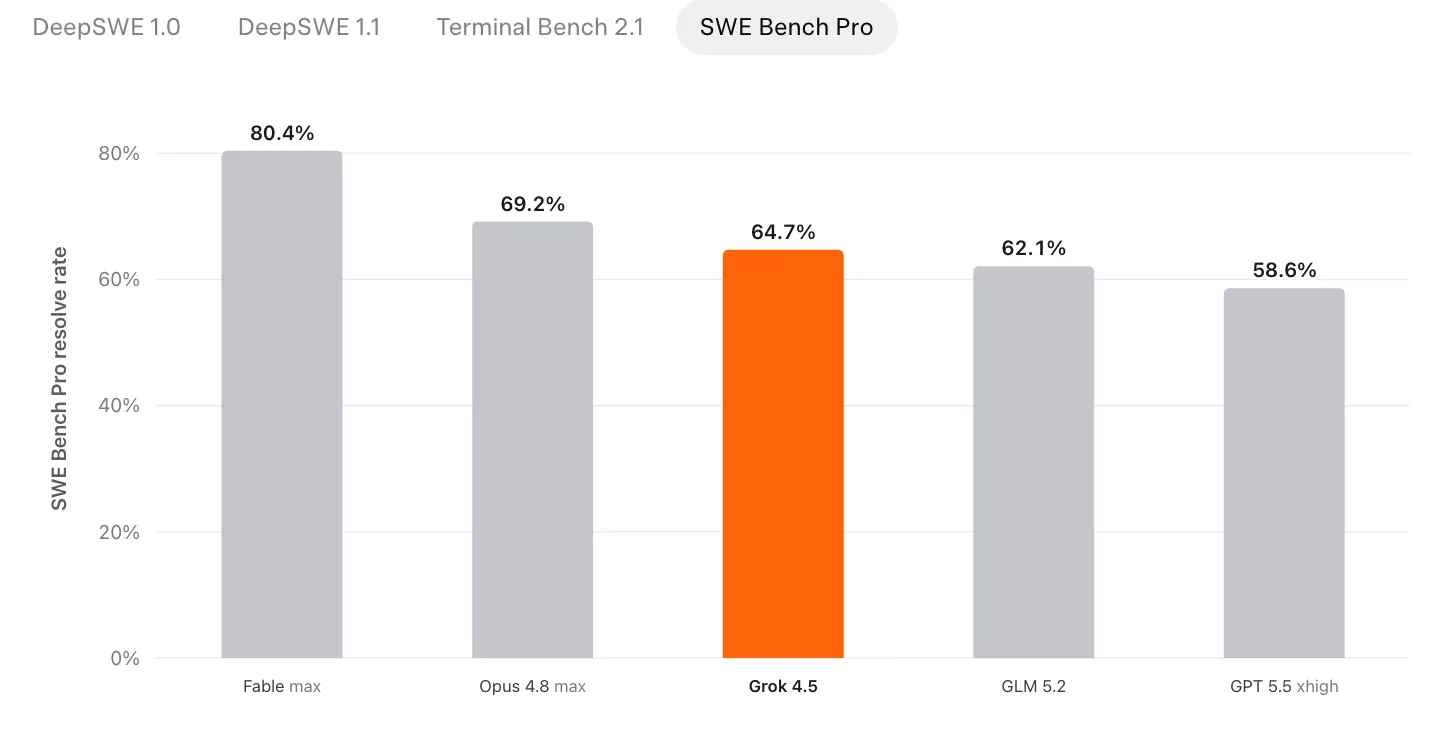
Şirketin benchmark karşılaştırmaları, GPT 5.6 yerine GPT 5.5 ile yapıldı. Bunun nedeni, GPT 5.6'nın da Çarşamba günü, Grok 4.5'in duyurusundan saatler sonra piyasaya sürülmüş olması.
SpaceXAI, Grok 4.5'i yakın zamanda satın aldığı Cursor AI ile işbirliği içinde, Colossus'taki on binlerce Nvidia GB300 GPU üzerinde eğitti. Colossus, Memphis'te bulunan ve toplam kapasitesi 200.000'den fazla GPU'ya ulaşan bir süper bilgisayar. Aynı benchmark'larda onun üzerinde yer alan modelleri geliştiren laboratuvarlar ise bu donanıma yakın bir şeye bile sahip değil. Ortaya çıkan model rekabetçi, ancak birinci değil.
Bu durum, Grok'un birden fazla sürümünde de görülen bir model. SpaceXAI, sürekli olarak devasa hesaplama gücü ve üçüncülük puanlarıyla ortaya çıktı. Grok 4.5 ile değişen şey ise fiyatlandırma ve eğitim sinyali oldu.
Modelin Asıl Gücü Nerede?
Daha iyi argüman, ham performans değil; verimlilik matematiği. SWE Bench Pro görevlerinde Grok 4.5, her bir işi tamamlamak için ortalama 15.954 çıkış token'ı kullandı. Opus 4.8 ise aynı iş için 67.020 token tüketti. Bu, 4.2 katlık bir fark anlamına geliyor.