Epoch AI’nin 29 Mayıs tarihli analizine göre Açık ağırlıklı modeller, Ocak 2026’dan bu yana en iyi kapalı modellerin ortalama dört ay gerisinde kaldı.
Ollama ve LM Studio ücretsiz. Küçük modeller yaklaşık 8 GB VRAM veya Mac birleşik belleği gerektiriyor ve LM Studio tamamen çevrimdışı çalışabiliyor.
Alibaba’nın 2,4 trilyon parametreli Qwen 3.8-Max gibi en büyük açık modeller tüketici donanımının çok ötesinde kalıyor ve kapalı modeller Alibaba’nın kendi karşılaştırmasında 31 testin 24’ünü kazandı.
Açık ağırlıklı yapay zeka modelleri artık en iyi kapalı modellerin ortalama sadece yaklaşık dört ay gerisinde ve giderek artan sayıda model muhtemelen zaten sahip olduğunuz donanımda çalışıyor.
“Açık ağırlık” şirketin modelin öğrendiği her şeyi içeren ağırlık dosyalarını yayınlaması anlamına gelir, böylece herkes indirebilir ve çalıştırabilir. İki ücretsiz program Ollama ve LM Studio geri kalanını üstlenir ve Ollama kütüphanesindeki Gemma 4 indirmeleri yaklaşık 4,6 GB ile 20 GB arasında değişir.
Açık modellerle ayda 20 dolar yapay zeka aboneliği ödemenize veya sohbetlerinizi başkasının sunucularına göndermenize gerek yok. Bu rehber yapay zeka modellerini doğrudan bilgisayarınıza nasıl indireceğinizi ve çalıştıracağınızı, hangi donanıma ihtiyacınız olacağını ve Ollama ve LM Studio gibi ücretsiz araçlarla nasıl başlayacağınızı anlatıyor.
Para tasarrufu yapmak, sohbetlerinizi özel tutmak veya kendiniz özelleştirebileceğiniz yapay zeka modelleriyle denemeler yapmak istiyorsanız yerel bir yapay zeka asistanı kurmak sandığınızdan daha kolay olabilir.
Neden yapay zeka modelini kendi makinenizde çalıştırmalısınız
Bulut tabanlı bir sohbet robotu her istemi şirketin sunucularına gönderir ve Decrypt’in gizlilik odaklı yapay zeka araçları incelemesinde bildirildiği üzere bir mahkeme OpenAI’den ChatGPT günlüklerini, silinenler dahil, saklamasını emretti. Yerel bir model sohbeti bilgisayarınızda tutar ve kimse izniniz olmadan kullanamaz.
LM Studio dokümantasyonu uygulamanın “tamamen çevrimdışı çalışabildiğini, sadece önce bazı model dosyaları almanız gerektiğini” söylüyor ve bir sohbete eklenen belgelerin de tamamen çevrimdışı kullanılabildiğini belirtiyor.
Ücretli sohbet robotlarına abonelik ayda yaklaşık 20 dolar tutarken burada bahsedilen yazılım ücretsiz. Maliyet muhtemelen zaten sahip olduğunuz donanıma kayıyor.
Lisanslar indirilen ağırlıklarla ne yapabileceğinizi belirler. DeepSeek’in R1 serisi MIT Lisansı altında ve model kartı modellerin “ticari kullanıma izin verdiğini, her türlü değişiklik ve türev çalışmaya izin verdiğini” söylüyor, Google’ın Gemma 4’ü ve OpenAI’ın gpt-oss’u Apache 2.0 altında yayınlanıyor.
Açık kaynak lisansı olan Apache veya MIT altında modeller çalıştırmak modelle istediğiniz gibi kullanma, değiştirme ve yapma özgürlüğü verir. Bu sayede belirli bir modelin ihtiyaçlarınıza daha iyi uyan geliştirilmiş ve değiştirilmiş sürümlerine erişebilirsiniz. Belki tıp alanında iyi bir modele ihtiyacınız var, kodlama becerisinin ne kadar iyi olduğu umurunuzda değil. Bu düzeyde kişiselleştirme yalnızca özelleştirilmiş modellerde mümkün.
Donanımınız gerçekten neyi çalıştırabilir
Modeller eğitim sırasında ayarlanan iç sayılar olan parametrelerle boyutlandırılır ve indirme boyutu onlarla birlikte büyür. Model grafik kartınızın video belleği olan VRAM’e veya işlemci ve grafik çipinin paylaştığı Mac’in birleşik belleğine sığmalıdır.
Genel kural olarak en az 8 GB VRAM isteyeceksiniz, bu sıkıştırıldığında sığabilecek. Ancak ciddi kullanıcılar 24 GB VRAM veya daha fazlasına sahip bir oyun GPU’su satın almalı, GPU’ları yığmalı veya Mac Mini veya Nvidia DGX Spark gibi birleşik belleğe sahip özel yapay zeka kasaları veya makineleri satın almalı.
Kuantizasyon her ağırlığı daha az bit ile saklayarak modeli küçültür. Hugging Face dokümantasyonu bunu ağırlıkların ve aktivasyonların “genelde 32 bit kayan nokta float32 yerine 8 bit tamsayı int8 gibi düşük hassasiyetli veri tipleriyle temsil edilmesi” olarak açıklar, bu da bir miktar doğruluk pahasına bellek kullanımını azaltır.
LM Studio’nun sistem gereksinimleri macOS 14 veya daha yeni sürümleri çalıştıran Apple Silicon Mac’lerde 16 GB veya daha fazla RAM öneriyor, 8 GB’lık Mac’ler daha küçük modelleri kaldırabiliyor. Windows’ta en az 16 GB RAM ve 4 GB özel VRAM ve AVX2 işlemci desteği öneriyor ve Intel tabanlı Mac’ler desteklenmiyor.
Ollama kütüphanesi Gemma 4 26B’yi 16 ila 19 GB ve 31B sürümünü 19 ila 20 GB olarak listeliyor. OpenAI’ın gpt-oss-20b’si yalnızca 16 GB bellek gerektiriyor ve gpt-oss-120b 80 GB içinde çalışıyor.
Ollama ve LM Studio nasıl kurulur
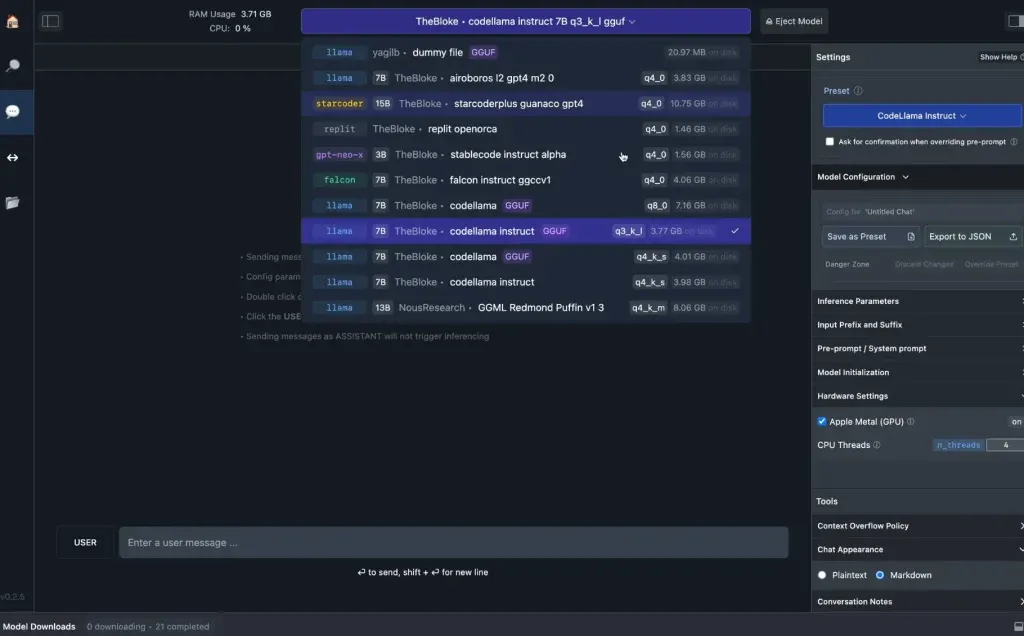
LM Studio muhtemelen en iyi seçimdir çünkü güzel cilalı bir grafik kullanıcı arayüzü sunar. Ollama ise terminal içinde çalışmayı tercih eden geliştiricilere ve daha deneyimli kullanıcılara yöneliktir.
LM Studio için işletim sisteminiz için yükleyiciyi lmstudio.ai’den indirin, uygulama içinde bir model arayın, ağırlıklarını indirin ve bir sohbet açın. Uygulama açık modellerin yayınlandığı kamu merkezi Hugging Face’i arar.
Ollama için macOS ve Linux kullanıcıları curl -fsSL https://ollama.com/install.sh | sh komutuyla kurar ve Windows kullanıcıları PowerShell’de irm https://ollama.com/install.ps1 | iex komutunu çalıştırır, her ikisi de Ollama’nın indirme sayfasında listelenir.
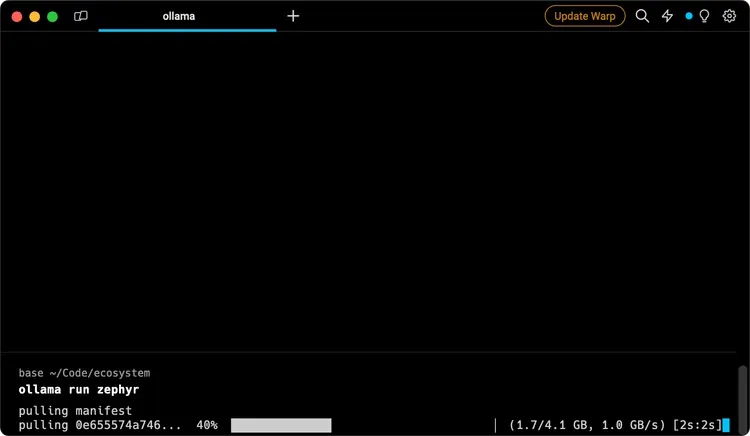
ollama pull gemma4:e2b yazmak bir modeli indirir ve ollama run gemma4:e2b bir sohbet açar, /bye çıkışı sağlar, bu Ollama’nın hızlı başlangıcına göre. Program ayrıca http://localhost:11434 adresinde yerel bir API açar, böylece makinenizdeki diğer uygulamalar modeli kullanabilir.
“ :cloud,” ile biten model adları, örneğin gemma4:cloud, Ollama’nın bulutunda çalışan ve indirme gerektirmeyen bulut modelleridir, gizlilik önemliyse bunları atlayın. Yine de daha güçlü modellere ihtiyaç duyanlar için iyi bir ikinci seçenektir: API üzerinden işlenen çağrılar ve istemler sağlayıcıların sunucularında saklanmaz ve modellerin eğitiminde kullanılmaz.
Apache 2.0 altında Ollama’da bulunan Gemma 4 için Google’ın Çoklu Token Tahmini taslakçıları, küçük bir modelin birkaç token önermesi ve büyük modelin bunları birlikte kontrol etmesiyle gerçekleşen spekülatif kod çözme sayesinde üretimi 3 kata kadar hızlandırır.
Google, “hedef model taslağı ile anlaştığında tüm diziyi tek bir ileri geçişte kabul eder” dedi ve hedef model aynı geçişte kendi ek bir token’ını ekler.
Yerel modeller Model Context Protocol kısaltması MCP sunucuları aracılığıyla web araması ve dosya erişimi kazanır ve LM Studio 0.3.17 sürümünde desteği ekledi.
Yerel modellerin buluta göre hâlâ kaybettiği noktalar
Dört aylık ortalama en yetenekli açık modelleri tanımlar ve en büyükler tüketici donanımının çok ötesindedir. Alibaba’nın Qwen3.8-Max’i toplam 2,4 trilyon parametreye sahip, her an 95 milyar aktif, gpt-oss-120b’nin çalıştığı 80 GB bellek ile karşılaştırıldığında.
Bir model VRAM’den sistem RAM’ine taşındığında yanıtlar çok daha yavaş olabilir ve daha büyük bağlam pencereleri daha fazla bellek ister. Gemma 4’ün küçük modelleri 128K token bağlam penceresi sunar, modelin aynı anda göz önünde bulundurabileceği metin miktarı, daha büyük olanlar ise 256K.
Bulut servisleri böyle bir planlama gerektirmez ve arkasındaki öncü modeller en zor testlerde hâlâ liderdir.
Yapay zekayı özel kullanmak istiyorsanız kendi incelememiz “makineden çıkmaması gereken günlük taslaklar için kendi barındırılan yerel model ile xPrivo’yu” ve “web alma ihtiyacı duyduğunuzda ve API çağrısı ödünleşimini kabul ettiğinizde Kagi’yi” önerdi.