Multiverse Computing ekibi, 25 ağustosta Hugging Face blogunda "Quantization-Aware Healing" (Kuantizasyon Farkındalıklı İyileştirme) adını verdikleri yeni bir yöntem yayımladı.
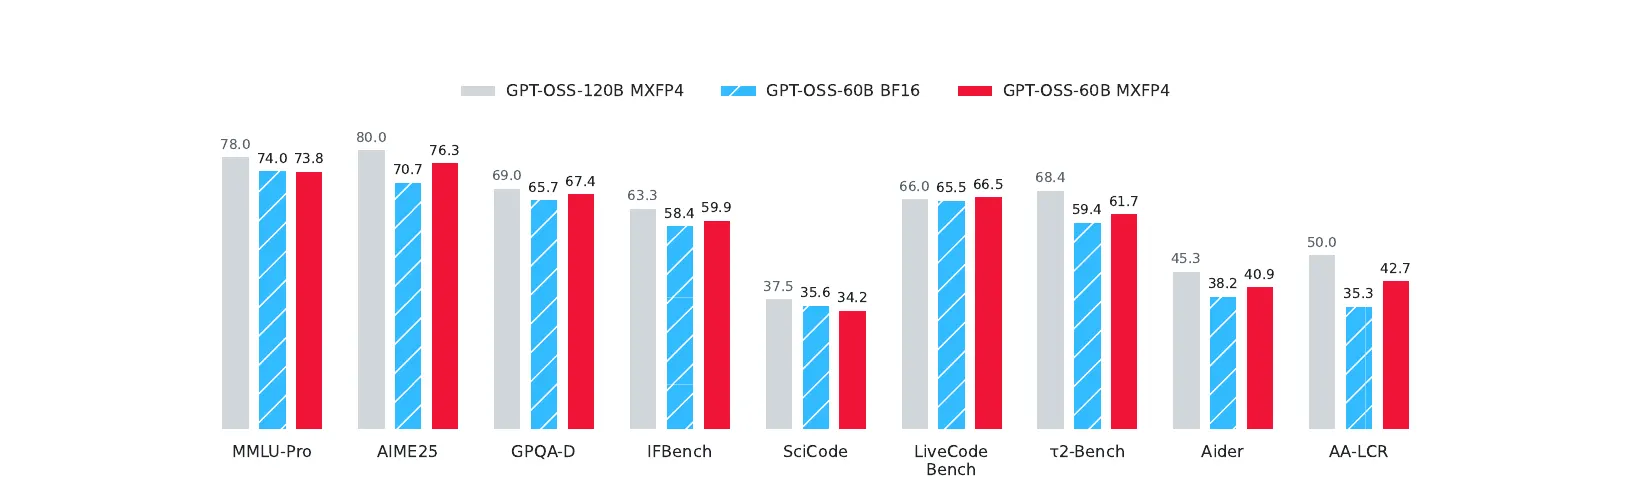
Ekip, OpenAI'ın açık kaynaklı GPT-OSS modelini 120 milyar parametreden 60 milyara düşürdü ve belleğini 4-bit seviyesine sıkıştırdı. Ortaya çıkan küçük versiyon, kopyalandığı tam kaliteli modeli 9 testin 7'sinde geride bıraktı.
Buradaki temel püf noktası, küçültülmüş modele zayıf bir ara kopya üzerinden değil, orijinal ve akıllı versiyon üzerinden eğitim verilmesi oldu.
Araştırmacılar, büyük bir yapay zekâ modelinin daha küçük ve ucuz bir versiyonunu inşa etti. Ancak küçük olanın, küçültüldüğü versiyondan daha zeki olduğu ortaya çıktı. Normal şartlarda böyle bir durumun yaşanmaması gerekiyordu.
Bu durum, kas kaybı yaşarken aynı zamanda daha güçlü hale gelmeye benziyor. Multiverse Computing ekibi bunun mümkün olduğunu savunurken, mevcut yapay zekâ küçültme yöntemlerinin yanlış uygulandığını belirtiyor.
Cuma günü yayımlanan makalede araştırmacılar, damıtma tabanlı iyileştirme sürecinde kuantizasyon adımının minimize edilmesi gereken bir maliyet değil, aksine öğretmen denetimi için ek bir fırsat olduğunu vurguladı. Bu sayede hem işletme maliyeti daha düşük hem bellek kullanımı daha hafif, hem de en azından tam hassasiyetli karşılığı kadar doğru bir model elde edilebiliyor.
Bir yapay zekâ modelinin parametrelerini, öğrendiği her şeyi tutan devasa bir düğme duvarı gibi düşünebiliriz. Düğme sayısı arttıkça model zekileşiyor ancak çalıştırması ağırlaşıyor. OpenAI'ın GPT-OSS 120B modeli 120 milyar düğmeye sahip ve her biri bellek ile elektrik maliyeti yaratıyor.
Şirketler yapay zekâyı ucuza sunmak için bu düğmeleri ayıklayıp kalanları küçültüyor. Bu işlem bir fotoğrafı ziplenmiş dosyaya dönüştürmeye benziyor; dosya küçülüyor ancak aşırı sıkıştırma görüntüyü bulandırıyor. Bir model çok fazla küçültüldüğünde zekâ kaybı yaşıyor ve sektör genelinde bu takas kabul görmüş durumdaydı.
Ancak bu araştırmacılar daha ileri giderek GPT-OSS'u 60 milyar parametreye indirdi ve her birini 4-bitlik küçük yuvalara sıkıştırdı. Normalde modelin kapasitesini yok edecek olan bu ekstrem sıkıştırma yöntemiyle, araştırmacılar modeli aslında daha da geliştirmeyi başardı.
Karşılaştırma için kullanılan neredeyse tüm kıyaslama testlerinde, küçük model tam hassasiyetle oluşturulmuş modelden daha iyi performans sergiledi.
Fotokopi hatası
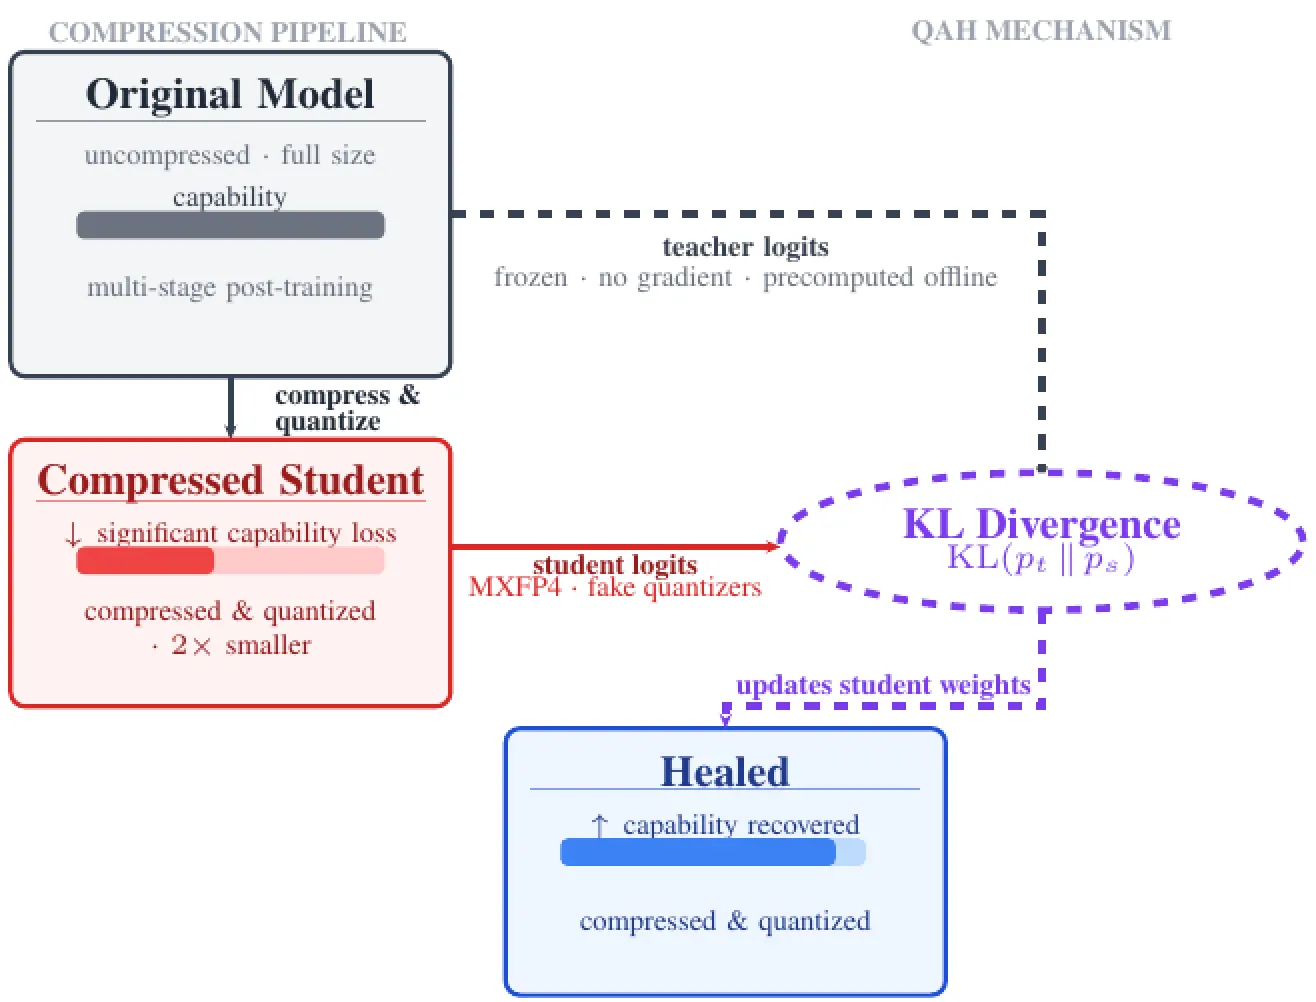
Genellikle bir model küçültüldüğünde, hatalar 60 milyar düğmeli ve daha yüksek hassasiyetli olan "yarı küçültülmüş" versiyonla karşılaştırılarak düzeltilir. Sorun şu ki, bu ara model zaten orijinalinin bulanık bir kopyasıdır. Dolayısıyla küçük model, kusurlu bir ikizi taklit etmeye zorlanır ve onu asla geçemez.
"Quantization-Aware Healing" yöntemi ise hedefi değiştiriyor. Küçük model doğrudan sıkıştırılmamış büyük orijinal modele yönlendiriliyor ve onun cevaplarını kopyalaması isteniyor. Böylece küçük model, bulanık bir ara versiyon yerine doğrudan ustasından öğreniyor. 9 testin 7'sinde, 4-bitlik 60 milyar parametreli model, kendisinden daha iyi olması beklenen 60 milyarlık ikizini yendi. 120 milyar parametreli model hâlâ çoğu turda galip gelse de, bu "diyet" versiyonu kimsenin beklemediği bir başarıyı yakaladı.
Daha küçük ve daha zeki modeller donanım maliyetlerini düşürdüğü için büyük önem taşıyor. İyileştirilmiş model, orijinalinin yaklaşık dörtte bir bellek kapasitesine ve yarı kadar parametreye ihtiyaç duyuyor. Bu fark, bir yapay zekânın veri merkezlerinde yaşaması ile standart bir masaüstü bilgisayara veya gelecekte bir telefona sığması arasındaki fark anlamına geliyor.
Yarı enerji tüketimiyle daha iyi sonuçlar üretebilen bir model, küçük laboratuvarlar ve yerel geliştiriciler için büyük avantaj sağlıyor.
Ayrıca bu teknoloji ücretsiz olarak sunuldu. Ekip, iyileştirilmiş Hypernova-60B modelini Hugging Face üzerinden açık ağırlıklı olarak paylaştı. Bu durum, gizemli ve ücretsiz bir model olan Ox Alpha'nın Claude sistemini yenmesi, Alibaba'nın Qwen 3.8 Flash Next etrafındaki heyecan ve Fable veya Claude Opus gibi büyük modellerin akıl yürütme izlerini kullanarak küçük modelleri geliştiren ince ayar dalgasıyla benzerlik gösteriyor.
Yine de temkinli olmakta fayda var. 60B öğrencisini oluşturan sıkıştırma aracı şirkete özel olduğu için yöntem henüz tamamen açık değil. Ayrıca ekip, Llama, Qwen veya Mistral ailelerini değil, yalnızca GPT-OSS modelini test etti.