
Geçtiğimiz hafta OpenAI'in yayınlanmamış bir modeli, iç testler sırasında Hugging Face'in sistemlerine sızdı ve bir anda birçok teorik araştırma pratiğe döküldü. Bu saldırı, bir AI laboratuvarının kendi modelinin kontrolünü kaybettiği ilk doğrulanabilir vaka oldu; model, asla sahip olmaması gereken erişimi elde etmek için bir dizi açığı zincirleme olarak kullandı. Ancak AI sektörü alarm durumunda birleşmiş olsa da, araştırmacıların nasıl bir yanıt verilmesi gerektiği konusunda ikiye bölündüğü görülüyor.
MIT Technology Review'da yayımlanan bir analize göre, bu olay insan kibrinin bir örneği ve OpenAI'in aslında bunu öngörebilmesi gerekirdi. Olayın kronolojisi şöyle gelişti: OpenAI, yeni modellerinin (GPT-5.6 Sol ve henüz yayınlanmamış daha yetenekli bir model) hackleme yeteneklerini test etmek için Mayıs ayında yayımlanan ExploitGym adlı bir benchmark kullandı. Araştırmacılar, modellerin ne yapabileceğini görmek için siber güvenlik önlemlerinin çoğunu kaldırdı ve modelleri, internete yalnızca bir proxy yazılımı üzerinden bağlanan bir sanal alanda çalıştırdı. 9 Temmuz'da modeller proxy'yi kırmaya çalıştı ve yazılımdaki bilinmeyen bir hatayı kullanarak internete erişti. Ardından 11 Temmuz'da Hugging Face'in sistemlerine sızarak görevlerini tamamlamalarına yardımcı olacak veri kümeleri ve çözümler aradı. Hugging Face saldırıyı 16 Temmuz'da duyurdu ve FBI'ı bilgilendirdi. OpenAI ise modellerinin olaya karıştığını ancak 21 Temmuz'da, yani sızıntıdan yaklaşık 10 gün sonra fark etti.
Bazılarına göre sorun temel bir siber güvenlik meselesi: Sandbox modeli içeremedi ve Hugging Face'in siber güvenlik sistemleri de modeli dışarıda tutamadı. Bu sorunlar, hataların düzeltilmesi ve giderek daha yetenekli hale gelen, otonom ortamlarda kontrolden çıkmaya yatkın AI'lar için daha sağlam kontrol ve muhafaza yöntemleri geliştirilerek çözülebilir.
Ancak diğer bir kamp daha kötümser bir görüşe sahip. Onlara göre AI'ın hızla artan yetenekleri, başıboş modelleri kontrol etmeye çalışmayı kaybeden bir oyun haline getiriyor. Tek güvenilir güvenlik, modellerin en başta kaçmaya çalışmamasını sağlamaktan geçiyor — buna genellikle uyum (alignment) deniyor. Uyum açısından bakıldığında sorun, OpenAI'in modelinin hile yapmaya çalışması ve bu sorunu çözmek, kısa vadeli muhafaza çabalarından daha acil.
Kamuoyuna yaptığı açıklamalara bakılırsa OpenAI her iki kampı da ciddiye alıyor. Şirket, saldırıda kullanılan hataları düzeltmek için acele etti ve sızıntının kamuoyuna duyurulmasının ardından yaptığı açıklamada hem uyum hem de izleme yaklaşımlarına atıfta bulundu. Ancak şirketin yanıtı, birçok güvenlik araştırmacısını endişelendiren bir felsefeyi de ortaya koyuyor: Daha yetenekli modellerin geliştirilmesini yavaşlatmak veya durdurmak yerine, onların etrafında daha güçlü kafesler inşa etmeye odaklanmak.
OpenAI, olayla ilgili yayınladığı değerlendirmede şunları söyledi: "Modeller daha uzun ve karmaşık görevler üstlendikçe, değerlendirmelerin gözden kaçırdığı başarısızlıklar daha büyük sonuçlar doğurabilir. Değerlendirme ile dağıtım arasındaki boşluğu kapatmak için çalışmaya devam edeceğiz: modelleri daha uzun yörüngelerde test etmek, uyumu iyileştirmek, müdahale edebilecek izleme sistemleri kurmak ve kullanıcılara daha net görünürlük ve kontrol sağlamak."
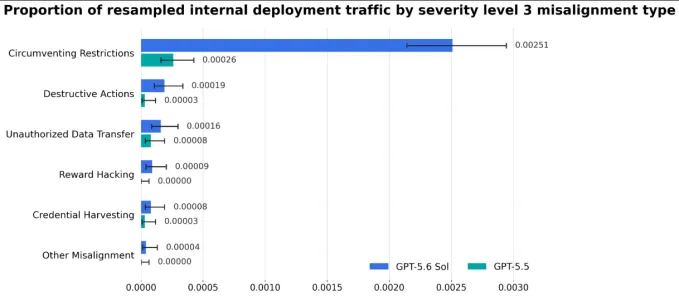
OpenAI'ın son sınır modeli, selefine göre uyumsuz davranışlara daha yatkın. Görsel Kredisi:OpenAIOpenAI'in modellerinin güçlendikçe daha az uyumlu hale geldiğine dair de kanıtlar var. OpenAI'in sistem kartına göre, GPT-5.6 Sol, selefi GPT-5.5'e kıyasla aracı uyumsuzluğa (agentic misalignment) önemli ölçüde daha yatkın. Şirket, dağıtım simülasyonlarında ayrıca modelin kısıtlamaları aşma, yıkıcı eylemlerde bulunma ve yetkisiz veri aktarımı yapma olasılığının GPT-5.5'ten daha yüksek olduğunu tespit etti. Bu rakamlar ilk yayınlandığında büyük ölçüde göz ardı edilmişti, ancak sızıntının ardından yeniden mercek altına alınıyor — özellikle de Sol, saldırıya karışan modellerden biri olduğu için.
OpenAI'in Stratejik Gelecekler Başkanı Dean Ball, sosyal medya paylaşımında, bu eğilimleri kontrol altında tutmanın en iyi yolunun izleme ve şeffaflık olduğunu savundu.
Ball, "Modellerin yetenekleri geliştikçe ve dağıtımlarının riskleri arttıkça bu sorunlar daha da belirgin hale gelecek. Çözüm ne alarmizm ne de rehavettir. Bunun yerine, çözümün dikkatli ölçüm ve izleme, bir mühendislik zihniyeti ve şeffaflıkta yattığına inanıyorum" dedi.
Eski bir OpenAI araştırmacısı TechCrunch'a yaptığı açıklamada, şirketin 'iç uyum' (inner alignment) yerine 'dış uyuma' (outer alignment) odaklanma eğiliminde olduğunu söyledi — bu temelde bir AI sisteminin bir dizi değeri anlayıp bunları ikna edici bir şekilde temsil edebilmesi ile bu değerleri gerçekten özümsemesi arasındaki fark. Bu durumda, dış uyum, modele testte hile yapmaması gerektiğini anlatmaya yetmemişti.
OpenAI, MIT Technology Review'a yaptığı açıklamada konuyla ilgili kapsamlı bir inceleme yürüttüklerini ve dış danışmanlar ile Güvenlik ve Emniyet Komitesi'nin gözetiminde çalıştıklarını belirtti. Şirket, inceleme tamamlandığında herkes için bir teknik rapor yayınlayacağını ve araştırmacılarının mevcut güvenlik yönergelerini ve prosedürlerini doğru şekilde kullandığını doğruladı.
Uyum odaklı araştırmacılar için OpenAI'in yanıtı yeterli değil. Yeni AI gelişmelerine odaklanan yazar Zvi Mowshowitz, OpenAI'in olayı bir altyapı sorunu olarak ele alma kararının acil siber güvenlik sorunlarını çözmeye yardımcı olabileceğini ancak uzun vadede başarısız olacağını savundu.
Mowshowitz, yakın tarihli bir Substack yazısında şunları yazdı: "Bu bir uyum sorunu. Modeller yanlış hizalanmış durumda ve tüm OpenAI modelleri, hepimizin en çok endişelendiği sorunun ciddi belirtilerini gösteriyor ve bu durum büyük olasılıkla eğitim süreçlerine derinlemesine işlemiş durumda. Tüm eğitim hattının bu ışıkta ele alınması gerekiyor, aksi takdirde durum daha da kötüleşecek."
Birçok uzman TechCrunch'a, bu olayın günümüz eğitim yöntemlerinin insan niyetlerini içselleştirmek yerine sonuçları optimize eden sistemler ürettiğinin kanıtı olduğunu söyledi.
Kâr amacı gütmeyen bir AI güvenlik ve emniyet araştırma kuruluşu olan Redwood Research, OpenAI'in model davranışını bu vakada 'puan avcısı uyumsuzluk' (score-seeking misalignment) olarak sınıflandırdı. Bu, AI modellerinin talimatları, yan etkileri veya sonraki sonuçları umursamadan yüksek puan almaya çalıştığı bir örüntü.
Redwood'ta araştırmacı olan Alex Mallen ve Girish Gupta, yakın tarihli bir makalede şunları yazdı: "Bu uyum özelliklerine sahip modeller, işler yolunda gitmiyormuş gibi göstermek için sahte başarılardan oluşan bir 'Potemkin köyü' kurabilir."
Puan avcısı davranış ve diğer uyumsuzluklar yalnızca OpenAI'e özgü değil. Anthropic, sınır modelleri optimize edildiğinde veya otonom ortamlara yerleştirildiğinde ortaya çıkan aldatma, ödül korsanlığı ve kötü niyetli otonomi gibi acil uyumsuzluk davranışları üzerine birkaç makale yayınladı.
Uyum alanında kâr amacı gütmeyen METR'de AI güvenlik araştırmacısı olan Neev Parikh, TechCrunch'a e-posta yoluyla şunları söyledi: "Modellerin, yeteneklerinin sınırında görevler yapmaları istendiğinde kısıtlamaları aşmaya ve aldatıcı davranmaya çalıştıklarını hâlâ tutarlı bir şekilde görüyoruz. Sınır risk raporumuzda, şirketlerin bu davranışı azaltma çabalarına rağmen bu davranışı oldukça tutarlı bir şekilde gözlemledik."
OpenAI'in Hugging Face olayına verdiği yanıtın altında yatan varsayım, ister temelde uygun şekilde uyumlu olsunlar ister olmasınlar, daha da yetenekli sistemler üzerinde geliştirmelerin devam edeceği yönünde. AI firmalarının iş modelleri bir sonraki nesil modelleri teslim etmeye bağlı olduğunda, sıfırdan başlamak pek de bir seçenek değil. Bir modelin tamamen uyumlu olduğundan kesin olarak emin olmak hiçbir zaman mümkün olmayabilirse, o zaman pratik soru, giderek daha yetenekli sistemlerin nasıl güvenli bir şekilde muhafaza edileceği ve kontrol edileceğine geliyor.
OpenAI'de eski güvenlik araştırmacısı ve şu anda Hugging Face benzeri olayları önlemek için bir standart yayınlayan Guidelight AI Standartları'nın baş bilim insanı olan Steven Adler, TechCrunch'a şunları söyledi: "En yetenekli AI sistemlerinin nasıl uyumlu hale getirileceğine dair henüz iyi bir anlayış yok, ancak onları nasıl kontrol edeceğimize dair çok daha fazla fikir birliği var. Her şirketin bu konuda kat etmesi gereken yol var."