NVIDIA'ya göre robotik temel modeller kayda değer bir ilerleme kaydetti. Günümüzün en iyi sistemleri, doğal dil talimatlarını takip ederek çok çeşitli nesneleri tutma, yerleştirme, sıralama ve manipüle etme gibi görevleri yerine getirebiliyor.
Ancak bu modeller daha yetenekli hale geldikçe, onları titizlikle değerlendirmek alanın en zor çözülmemiş sorunlarından biri haline geldi. NVIDIA, bu blog yazısında temel sorunları ve bu sorunları çözmek için geliştirdikleri yöntemi tanıtıyor.
Mevcut Kıyaslamalar Neden Yetersiz Kalıyor?
Gerçek dünya testleri pahalı, yavaş ve tekrarlanması zor. Bir robotun gerçek dünyadaki performansını kapsamlı bir şekilde değerlendirmek için makul bir vekil çözüme ihtiyaç var. Simülasyon, büyük ölçekli robot değerlendirmeleri için doğal bir ortam sunuyor. Ancak mevcut kıyaslamaların çoğu birkaç kritik sorunu paylaşıyor.
Eğitim ve Değerlendirmede Görsel Alan Örtüşmesi
İlk olarak, politika eğitimi ve değerlendirmesinde kullanılan veri ve ortamlar neredeyse her zaman aynı görsel kaynaktan alınıyor. Bir model simülasyon verileriyle ince ayar yapıldığında ve aynı simülasyon ortamında değerlendirildiğinde, güçlü performans yalnızca modelin kurulumu ezberlediğini gösteriyor, genelleme yapabildiğini değil. Simülasyonun görsel kalitesi henüz gerçek dünya görüntü gözlemleriyle eşitlenmediği için bu, robot değerlendirmelerinde kritik bir sorun olmaya devam ediyor.
Real2sim yaklaşımları, inpainting veya Gaussian splatting gibi teknikler kullanarak gerçek dünya görüntülerinden fotogerçekçi ortamlar oluşturarak bu sorunu çözmeye çalışıyor. Ancak her sahne için kurulum süresi bir saati aşabiliyor ve bu da büyük ölçekli testleri pratik olmaktan çıkarıyor.
NVIDIA Kıyaslama Doygunluğuna Dikkat Çekiyor
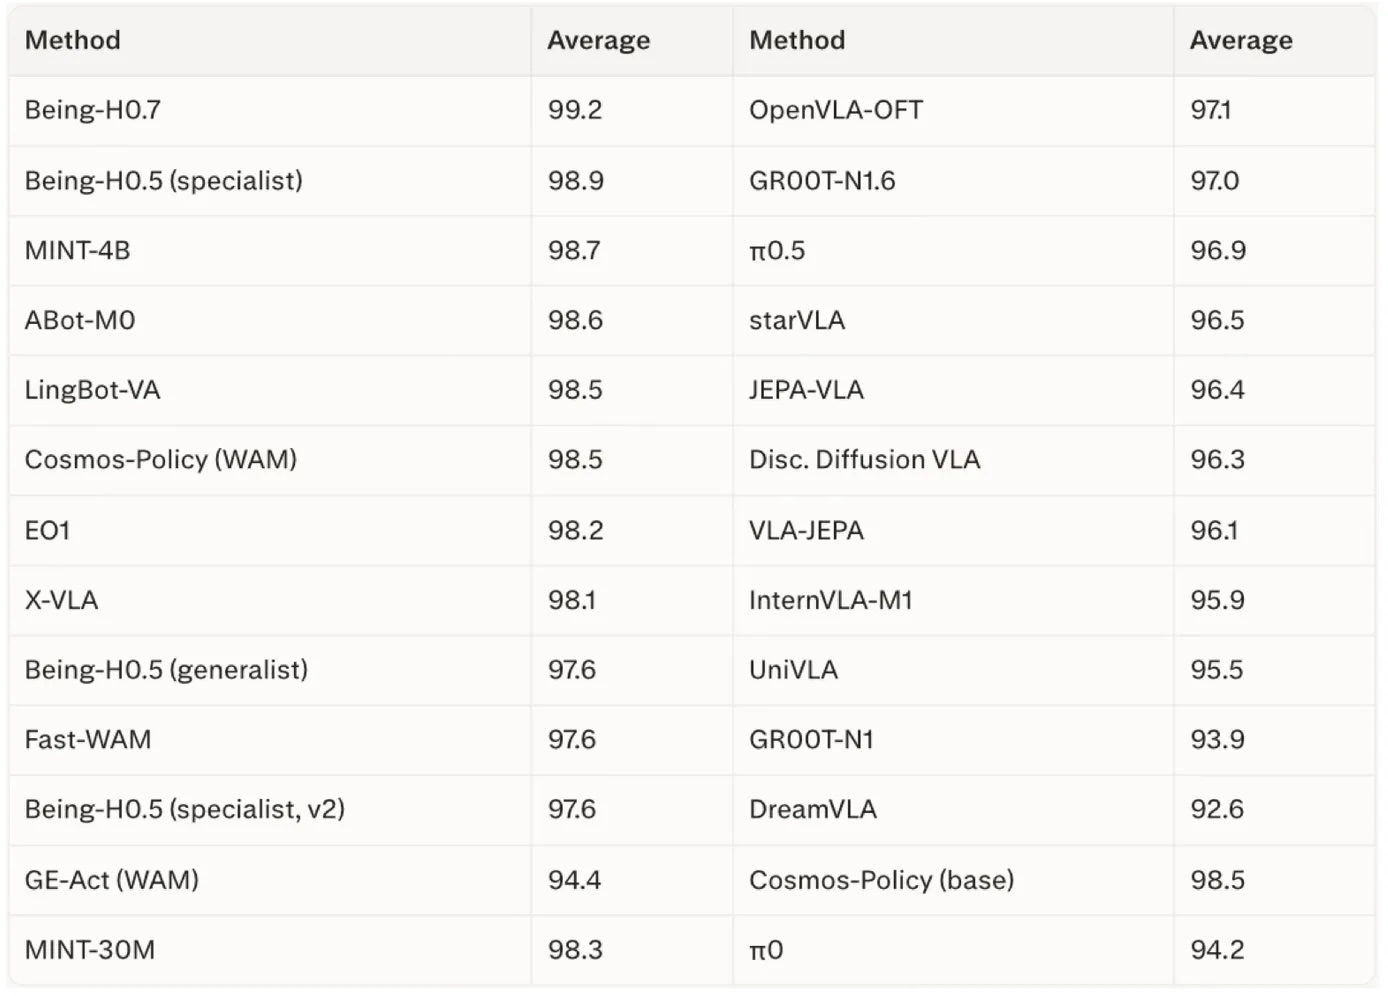
İkinci olarak, görev oluşturmak zahmetli bir iş. Çoğu kıyaslamanın nadiren güncellenen sabit bir görev seti var. Bu da hızla performans doygunluğuna yol açıyor: Modeller statik görev setlerinde hızla maksimum puanlara ulaşıyor ve hangi modelin gerçekten daha yetenekli olduğunu ayırt etmeyi imkansız hale getiriyor. Her sistem aynı kıyaslamada yüzde 90'ın üzerinde başarı bildirdiğinde, bu rakamlar anlamını yitiriyor.
Tanısal Boşluk
Ayrıca daha derin bir tanısal boşluk var. İkili bir başarı/başarısızlık puanı, robotun neden başarısız olduğunu açıklamıyor. Robot nesnenin rengiyle mi kafası karıştı? Talimatın ifade ediliş şekliyle mi? Kaydırılmış bir kamerayla mı? Görevi belirli dil talimatına göre verimli bir şekilde mi yerine getirdi? Bu sorulara yanıt alınamadığında, araştırmacıların harekete geçecek çok az şeyi oluyor.
İstatistiksel Güvenilirlik
Her fizik motoru ve politika bir miktar rastgeleliğe tabidir. N denemede tek bir başarı oranı, bir politikanın gerçek performansı hakkında ne kadar güven duymanız gerektiği konusunda neredeyse hiçbir şey söylemez. Bir politika 10 denemede dokuzunda başarılı olursa, bu 'yüzde 90 başarı' politikası mıdır, yoksa küçük bir örneklemde şansı yaver giden yüzde 80 veya yüzde 95'lik bir politika da olabilir mi? Bunu araştırmak için Clopper-Pearson yöntemine bakıyoruz.
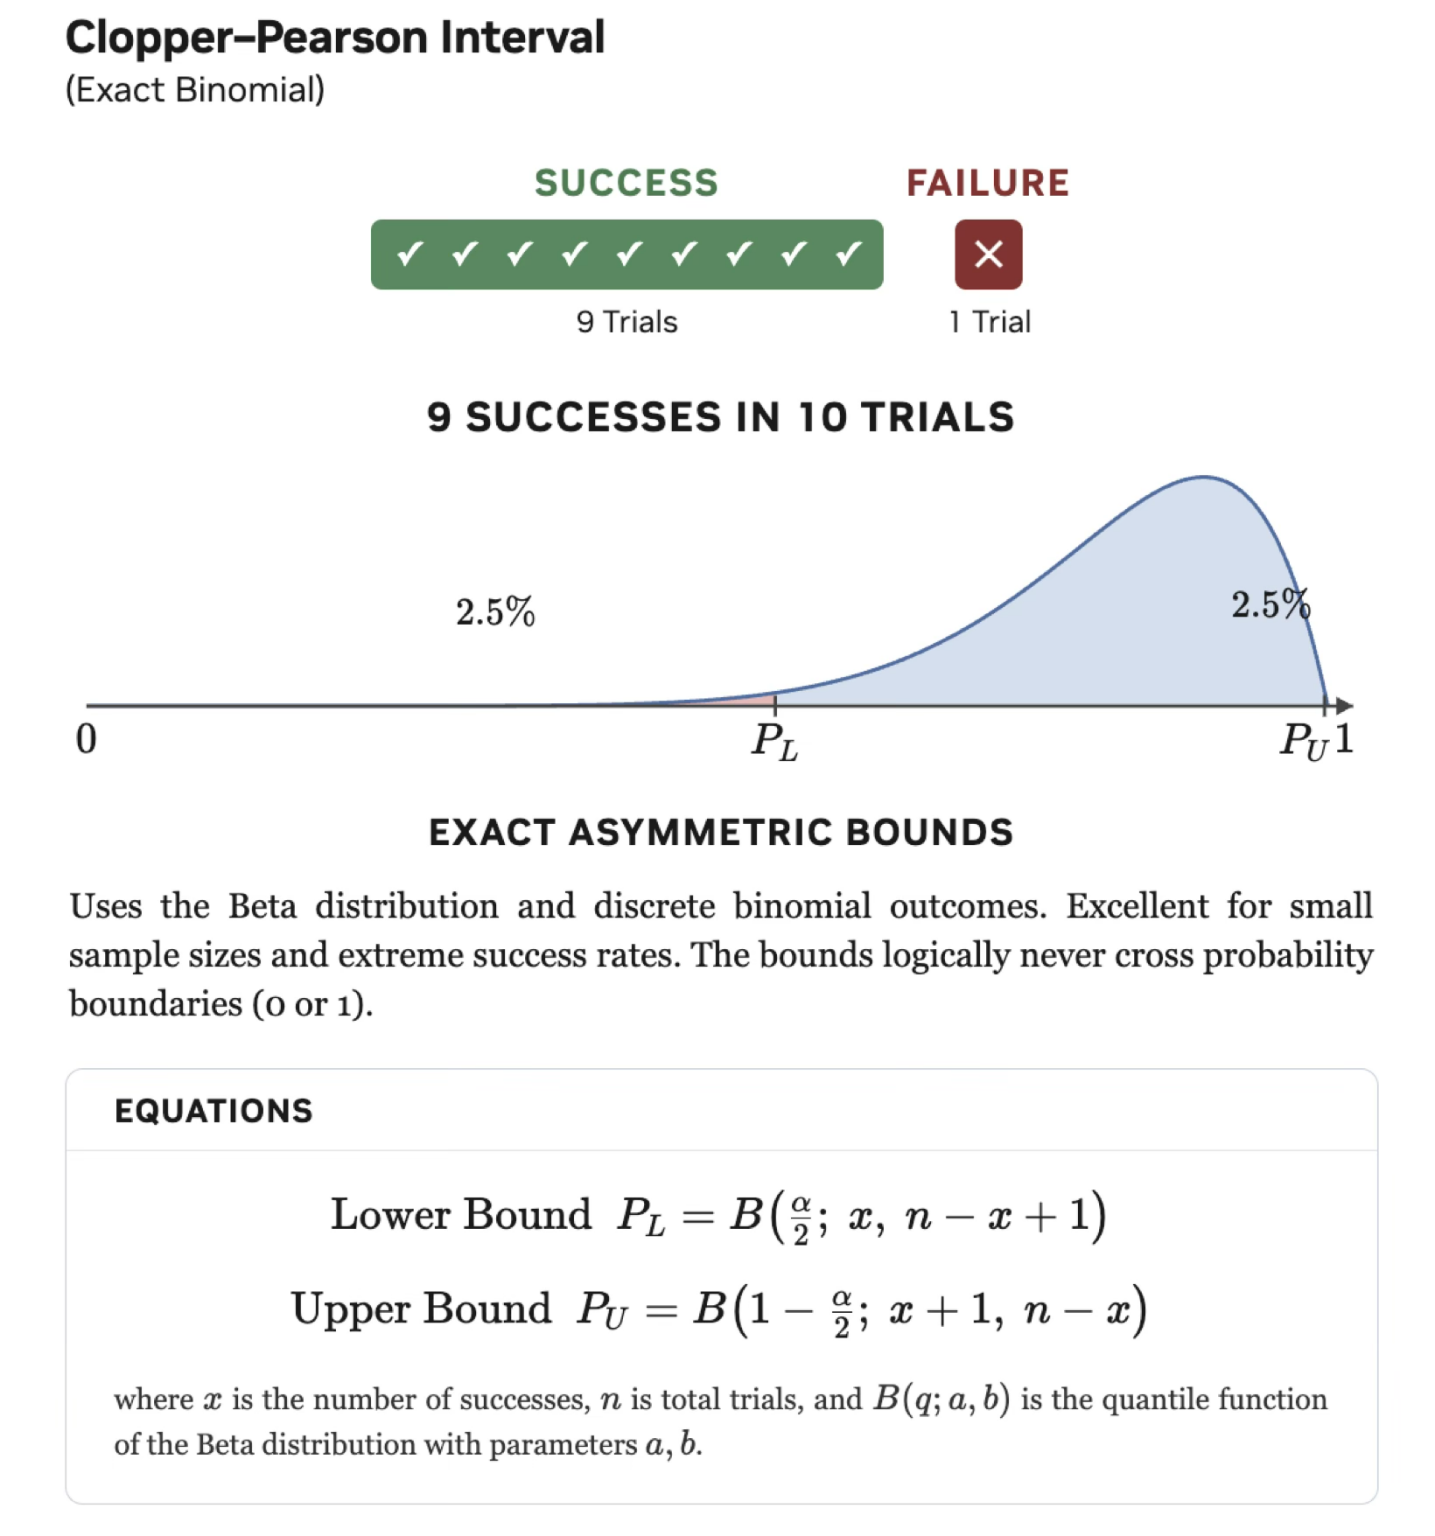
Clopper-Pearson yöntemi, başarı oranı etrafında bir binom güven aralığı oluşturmak için doğrudan binom dağılımından hesaplanan 'kesin' bir yöntemdir. Şu örneğe bakalım: Sadece 70 denemede gözlemlenen yüzde 90'lık bir başarı oranı için, yüzde 95'lik bir Clopper-Pearson güven aralığı tam 15,4 yüzde puanına (yüzde 80,5 ila yüzde 95,9 başarı oranı) yayılıyor. 1.030 denemede bu hata, ±2 yüzde puanlık bir banda (yüzde 88,0 ila yüzde 91,8 başarı oranı) daralıyor. Yayınlanan kıyaslamaların çoğu, iki politikanın performansını karşılaştırırken istatistiksel anlamlılık elde etmek için yeterli sayıda deneme yapmıyor.