Özet
xAI, en az beş gecikmenin ardından Temmuz sonundan bu yana Pazartesi günü Grok 4.7'yi yayınladı.
Model, GDPval ve AA-Briefcase'te Claude Fable 5.1'in ardından ikinci oldu ve elektrik mühendisliği kıyaslaması olan EEBench'te GPT-6 Astra'nın ardından ikinci sırada yer aldı.
Grok 4.7, SpaceX mühendislik verileriyle ek eğitim alan ve 2,1 trilyon parametre üzerinde çalışan Grok uygulaması, Cursor, Grok Build ve xAI API'de hemen kullanıma sunuldu.
Elon Musk'ın xAI şirketi Pazartesi öğleden sonra bugüne kadarki en iyi modeli olan Grok 4.7'yi yayınladı ve şirket modeli "aynı fiyat ve hızda Grok 4.6'ya göre kayda değer bir iyileşme" olarak tanımladı.
Yayın birkaç görünür gecikmenin ardından geldi. Musk Temmuz sonundan bu yana takvimi en az beş kez geri çekti: "dört hafta kaldı", ardından "birkaç hafta", ardından "3 ila 4 hafta", ardından 1 Eylül'de "10 gün", ardından 11 Eylül'de "pişmesi için birkaç güne daha ihtiyacı var".
xAI, modelin zor problemleri çözerken daha uzun süre harcadığını ve Grok 4.6'ya göre kendi cevaplarını daha sık çift kontrol ettiğini, şirketin şimdiye kadarki en güçlü güvenlik koruyucuları olarak adlandırdığı özelliklerle birlikte söyledi.
Musk X'te yaptığı paylaşımda Grok 4.7'yi "zeka, hız ve düşük maliyetin güçlü bir kombinasyonu" olarak nitelendirdi. Bu sefer bekleme listesi yok—model şu anda Grok uygulaması, Cursor, Grok Build ve xAI API'de canlı.
Grok 4.7 burada.
Aynı fiyat ve hızda Grok 4.6'ya göre kayda değer bir iyileşme.
— SpaceXAI (@SpaceXAI) 21 Eylül 2026
Grok 4.7, Grok 4.5'in bir geliştirmesi olan Grok 4.6'daki 1,5 trilyon parametreye kıyasla %40 artışla 2,1 trilyon parametre içeriyor. Maliyetler giriş tokenı başına milyon başına 2 dolar ve çıkış tokenı başına milyon başına 6 dolar. Parametreler bir modelin eğitim sırasında ayarladığı dahili ayarlar olup daha fazlası genellikle desenleri öğrenme kapasitesinin daha fazla olduğu anlamına gelirken tokenlar bir yapay zeka modelinin kaydedebileceği veya üretebileceği temel bilgi miktarıdır.
xAI ayrıca Musk'ın roket şirketi SpaceX'ten alınan ek eğitim verilerini de dahil etti: Starlink uydu telemetrisi, üretim kayıtları ve mühendislik arıza günlükleri. Sunulan vaat yalnızca internet metni üzerinde eğitilmiş her şeyden daha iyi donanım ve fiziksel sistemler hakkında akıl yürüten bir model.
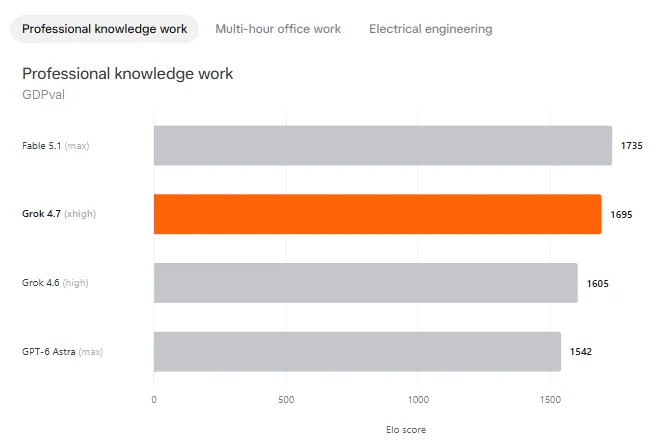
Bununla birlikte kıyaslama puanları tanıdık bir hikaye anlatıyor. GDPval her alanda çalışan profesyoneller tarafından doğrulanmış görevler kullanarak bir modelin yasal notlar, elektronik tablolar, sunumlar gibi gerçek ekonomik olarak değerli bilgi çalışmaları üzerindeki performansını ölçer ve satrançta kullanılan aynı eşleşmeli sıralama sistemi olan Elo derecelendirmesi olarak puanlar.
Grok 4.7 GDPval'de 1695 puan aldı. Claude Fable 5.1 tabloyu 1735 puanla zirvede tamamladı.
Artificial Analysis tarafından oluşturulan AA-Briefcase araştırmayı, analizi ve belge üretimini tek uzun göreve bağlayan çok saatlik ofis işini test eder ve Elo ölçeğinde puanlanır. Grok 4.7 1657 puan alırken Fable 5.1 1678 puan aldı. Aynı sonuç farklı test.
Cursor'un editörü içindeki gerçek kodlama görevleri için kıyaslaması olan CursorBench 4.0 doğruluğu her görevin tükettiği maliyet ve token sayısı karşısında gösterir. Grok 4.7 ortada kalıyor: GPT-5.6 Sol'un halefi GPT-6 Astra ve Claude Sonnet 5'e göre görev başına daha pahalı ancak her fiyat noktasında grafikte kazanan Fable 5.1'in gerisinde kalıyor.
Bu xAI için yeni bir kalıp değil. Grok 4.5 Temmuz'da sektördeki en büyük eğitim kümesiyle piyasaya sürüldü ve Claude ve OpenAI modellerinin ardından üçüncü sırada puan aldı. Ondan önce Grok 4.20 güvenilirliği hız ve kişilik için feda etti. Grok 4.6 da kodlama özerkliğinde öncü grupta geride kaldı.
Hiçbiri Grok 4.7'yi X, bağımsız uygulama veya Tesla'nın gösterge paneli üzerinden onunla konuşan milyonlarca insan için kötü bir ürün yapmaz. Bu sorularınıza cevap verme veya arabanızın ses asistanını güçlendirme olasılığı en yüksek modelin kendi üreticisinin kıyaslamalarının merdivenin en üstünden bir basamak aşağıya yerleştirdiği bir sistem üzerinde çalıştığı anlamına gelir.
Bu boşluk çoğu insan için liderlik tablosu konumundan fiyat etiketinin daha önemli olmasının nedeni. xAI ham yetenek açısından onların gerisinde kalsa bile Anthropic ve OpenAI'yi token başına maliyet konusunda sürekli olarak aşağı çekti ve "yeterince iyi ucuz ve her yerde" stratejisinin günlük kullanımın büyük kısmı için "en iyi ama daha pahalı"dan daha iyi olacağına bahse girdi.
Musk lansmandan günler önce beklentileri daha düşük tutmuş ve Grok 4.7'nin Anthropic'in daha yeni Opus 5.1'i değil Claude Opus 5.0 ile "kabaca aynı seviyede" olması gerektiğini yazmıştı; multimodal performansın hâlâ çalışmaya ihtiyacı vardı.
Aynı paylaşımda bir sonraki üç modeli özetledi: Grok 4.8 anlamlı bir adım yukarı Grok 4.9 "Astra/Fable sınıfında" ve Grok 5 olası bir öncü lider. Bu yükseltmelerin henüz bir çıkış tarihi yok. "Göreceğiz" diye yazdı.